
AI 定理证明论文精选 · 大模型推理 · AI 科学
AlphaGeometry 与 MaxProof 的区别:三种 AI 证明路线对比
三家都报出了漂亮的数学成绩,但它们证明的是三种不同的定理,验证器和搜索预算也完全不同。这篇讲清每个数字到底测了什么。
先搞清一件事
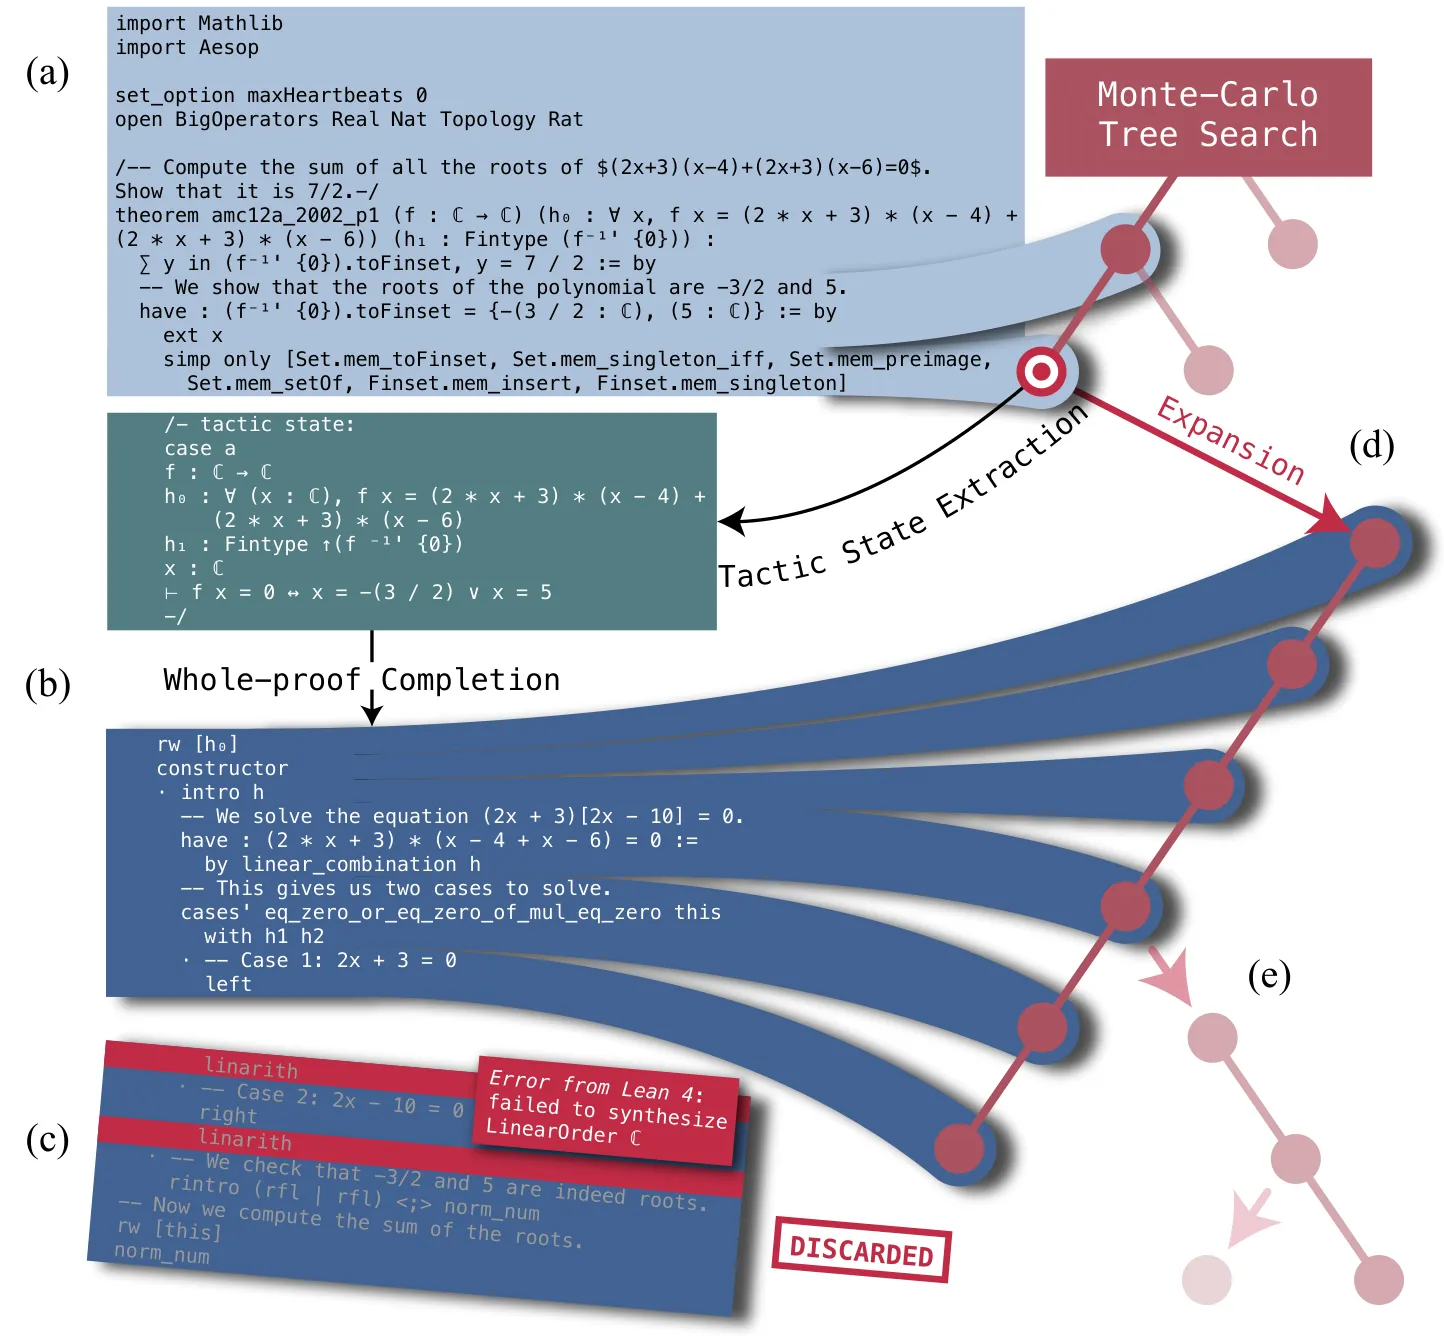
“AI 定理证明器”这个词底下至少压着三套几乎不共享任何机器的系统。AlphaGeometry 做竞赛几何:语言模型负责提出”构造”,符号推理引擎负责检查每一步,所以一份证明要么成立、要么不成立。DeepSeek-Prover-V1.5 写 Lean 4 证明,把证明助手的通过/不通过信号直接当作强化学习奖励,推理时再用蒙特卡洛树搜索的变体 RMaxTS 展开多条路径。MaxProof 面对人工评分的竞赛长证明,没有现成的符号检查器可用,只能堆测试时算力:先生成一大批候选证明,再用生成式验证器筛、修复、排序。三套系统其实排在一条光谱上,光谱的一端是验证器有多可信,而正是这一个设计选择解释了下面大部分分数差异。
还有一条线值得放在一起看:AI 辅助的形式化证明搜索把”生成加验证”的循环用到了公开未解问题上。它上榜的原因很实际:它把竞赛论文不讲的成本和规模行为暴露了出来。
关键数字
| 系统 | 证明什么 | 基准 | 分数 | 同一论文里的对照 | 验证层 |
|---|---|---|---|---|---|
| AlphaGeometry | IMO 级欧氏几何,自己的形式语言 | 2000–2022 年 30 道竞赛几何题 | 25/30 | 人类金牌选手平均 25.9;此前最佳自动化方法 10;去掉语言模型的符号引擎 18 | 符号推理引擎逐步检查 |
| DeepSeek-Prover-V1.5 | Lean 4 形式定理,高中难度 | miniF2F 测试集 | 63.5% | 相比 V1 同时改进训练与推理 | Lean 执行给出硬通过/不通过 |
| DeepSeek-Prover-V1.5 | Lean 4 形式定理,本科难度 | ProofNet | 25.3% | 同一系统、更难的基准 | Lean 执行 |
| MaxProof(基于 MiniMax M3) | 人工评分的竞赛证明 | IMO 2025 | 35/42,高于金牌线 | 系统级结果,不是单样本分数 | 生成式验证器加修复循环 |
| MaxProof(基于 MiniMax M3) | 人工评分的竞赛证明 | USAMO 2026 | 36/42,高于金牌线 | 同一搜索配置 | 生成式验证器 |
| AI 形式化证明搜索 | 公开未解问题,Lean 式验证 | Erdos 公开问题 | 解出 9/353 | 简单的”LLM 加验证器”循环也能复现成功,但在最难的问题上更贵 | 每次尝试由形式化检查器核验 |
| AI 形式化证明搜索 | OEIS 猜想 | OEIS 猜想 | 证明 44/492 | 同上 | 形式化检查器 |
两行需要多看一眼。AlphaGeometry 的 25/30 来自一份固定的 30 题集合(2000 到 2022 年),同一张表里的对照点才是真信息:人类金牌选手平均 25.9,此前最佳自动化方法 10,纯符号引擎不上语言模型停在 18。它比符号基线多出的那 7 分才是贡献,25 这个绝对数不是。MaxProof 的 35/42 则是搜索系统的分数:典型配置是 32 个初始候选、每个候选采 4 次验证、10 轮精修、每轮 4 个新子代。拿它和任何 pass@1 的单样本分数比,本身就是错的。
为什么同一个领域会同时出现 25/30、63.5% 和 35/42
因为这些分数本来就不在一张榜单上,也上不了同一张。几何配干净的形式语言是可判定的:符号引擎能确认每一步推理,所以 AlphaGeometry 能用 1 亿条合成定理和机器生成的证明做训练,还请前 IMO 奖牌得主评审,确认输出是有效的、可读的证明,而不是坐标硬算。Lean 4 也是机器核验,但搜索空间残酷得多:一份证明可能因为库名不对、缺引理、tactic 语法错而失败,而不是数学上不懂,这正是 DeepSeek-Prover 页面自己点出的脆弱性。竞赛长证明是三者里最难验证的,因为正确性是一段论证,不是一次项归约,MaxProof 的整个设计就是在承认它的验证器是最弱的一环。
基准这一层同样关键。MiniF2F 是跨系统的 488 道形式化竞赛级题目,存在的意义就是让 Lean、Isabelle、HOL Light 各家的系统至少有一个可比口径;63.5% 这个数字有价值,正是因为有共享基准。LeanDojo 补的是交互侧:一个带前提检索的 Lean 环境,因为一个看不到自己工作所在库的证明器,开局就先输。
验证器才是瓶颈,MaxProof 把原因摆在了台面上
这组对比里最有教益的数字不是分数。MiniMax 在更早的 M2 周期里做过一次交叉核验:单 rubric 验证器判为满分的 30 份 rollout,交给专家人工评审,只有 17% 完全正确,50% 部分正确,33% 错误。假阳性率高到这个水平的验证器,一旦当奖励信号用,就会教会策略去写又长、又排版漂亮、讨好评委但经不起独立复核的证明。
MaxProof 的对策是悲观聚合:坏例过滤、解答归一化、多个带 rubric 和不带 rubric 的评委,以及一个偏向拒绝的适应度分数。收益在它自己报告的失败案例里能看到。USAMO 2026 第 2 题,候选档案里躺着一份 6/7 的 oracle 证明,但排序器自己选中的答案只有 2/7,因为锦标赛机制偏好了一份更差的证明。IMO 2025 那边则干净得多:第 1 到 5 题各拿 7/7,第 6 题 0/7。剩下的错误已经不是生成问题,而是验证器分数扎堆时的选择问题。对照另外两个体制:DeepSeek-Prover 的 Lean 信号是白拿的,工程预算全花在 RL 和 RMaxTS 搜索上;MaxProof 必须把工程预算花在怎么让一个本来就不完美的评委保守到可以信。
成本、搜索,和公开问题给出的现实校准
形式化证明搜索那篇论文报了竞赛基准不肯报的成本:最强系统在 Erdos 问题上每题几百美元。对研究分诊来说便宜,对随手探索来说很贵。它也展示了循环的泛化幅度:Erdos 问题解出 9/353,OEIS 猜想证明 44/492,并且一个简单的 LLM 加验证器循环就能复现 headline 成功,差距只在最难的问题上拉开。把 AlphaGeometry 的 1 亿条合成定理、MaxProof 的 32 候选搜索群体放在一起看,规律是一致的:可验证的数学 AI 是一门搜索生意,算力在训练数据、RL 和推理时之间搬来搬去,从来不会凭空消失。
怎么选
- **领域里有可靠可判定的符号检查器:**走 AlphaGeometry 式神经符号搜索。合成带验证的训练数据,让模型负责创造性一跃,引擎逐步把关。这是唯一一个验证器既免费又精确的体制。
- **工作发生在 Lean 或 Isabelle 这类形式化库里:**走 DeepSeek-Prover 式验证器反馈 RL 加树搜索,配上 LeanDojo 那样的检索。预算要留给搜索,单次贪心采样会低估系统的真实能力。
- **产出是人工评分的长篇推理:**走 MaxProof 式群体级测试时扩展,并把验证器标定当成头号工程风险。先假设单 rubric 评委会高估,在信任奖励信号之前直接测假阳性率。
- **在为公开研究问题做分诊:**用形式化检查器兜底的生成加验证循环,每题几百美元的量级。先复现简单循环,只有最难的题才轮到昂贵的系统出场。
局限与存疑
这些数字没有一个能跨协议搬运。AlphaGeometry 的 25/30 是 30 道几何题、用的是它自己的形式语言,不覆盖组合和数论,题目还要预先翻译进它的输入格式。DeepSeek-Prover 的 63.5% miniF2F 是 Lean 4 里的高中形式数学,而它自己在本科难度的 ProofNet 上只有 25.3%,说明分数随题目难度掉得有多快。MaxProof 的 35/42 是 IMO 2025 分数,绑定特定的 32 候选搜索配置和自报的评分管线,它自己报告的 USAMO 第 2 题案例证明排序器仍可能从 6/7 和 2/7 之间挑错。公开问题的 9/353 和 44/492 是故意 modest 的数字:它们数的是没人证过的陈述里被新验证解决的数量。横切所有四个系统的开放问题是:这些配方能否泛化到没有几何那种干净可判定性、也没有 Lean 那种工业级内核的领域。决定这个领域是一堆 demo 还是一件研究工具的,是这个问题,不是再刷一个 leaderboard 点。
常见问题
哪个 AI 定理证明器最强?
没有统一排名,因为这些系统在不同验证器、不同协议下解决的是不同问题。AlphaGeometry 在带符号检查器的竞赛几何上拿 25/30;DeepSeek-Prover-V1.5 在 Lean 4 的 miniF2F 形式基准上拿 63.5%;MaxProof 靠重搜索和人工评分拿到 IMO 2025 的 35/42。直接比原始分数,会无视本页列出的口径差异。
AlphaGeometry 和人类金牌选手的区别?
接近,没有超过。同一组 30 道竞赛几何题上,AlphaGeometry 解出 25 道,人类 IMO 金牌选手平均解出 25.9 道。它明显超过的是此前最佳自动化方法的 10 道。
为什么 DeepSeek-Prover-V1.5 的 ProofNet 比 miniF2F 低这么多,两个评测基准有何不同?
63.5% 对 25.3% 反映的是基准难度,不是系统 bug。miniF2F 面向高中水平的形式陈述,ProofNet 面向本科数学;论文自己也提醒,Lean 证明可能败在库名和语法上,而不是数学内容。
MaxProof 的 IMO 2025 分数能和 pass@1 的模型分数直接对比吗?
不能。MaxProof 是系统级结果:典型配置生成 32 个初始候选、每个候选验证器采样 4 次、跑 10 轮精修、每轮新增 4 个子代。论文自己明确说,不应拿它和单样本分数 casually 对比。
AI 定理证明最大的未解问题是什么?
规模化之后的验证器可信度。单 rubric 评委判为满分的 30 份 rollout,专家评审只有 17% 完全正确。任何用生成式验证器做测试时扩展的系统都继承了这种假阳性风险,这也是为什么 MaxProof 的保守验证器设计和 Lean 系”白拿精确验证”的路线,是当下最重要的两条工作线。