
MindEye、Brain Diffuser、MinD-Vis:脑解码重建对比
同一 NSD 基准三个系统:MindEye 检索 93.6% 碾压,Brain Diffuser 赢 SSIM,MinD-Vis 的数字来自另一个数据集。
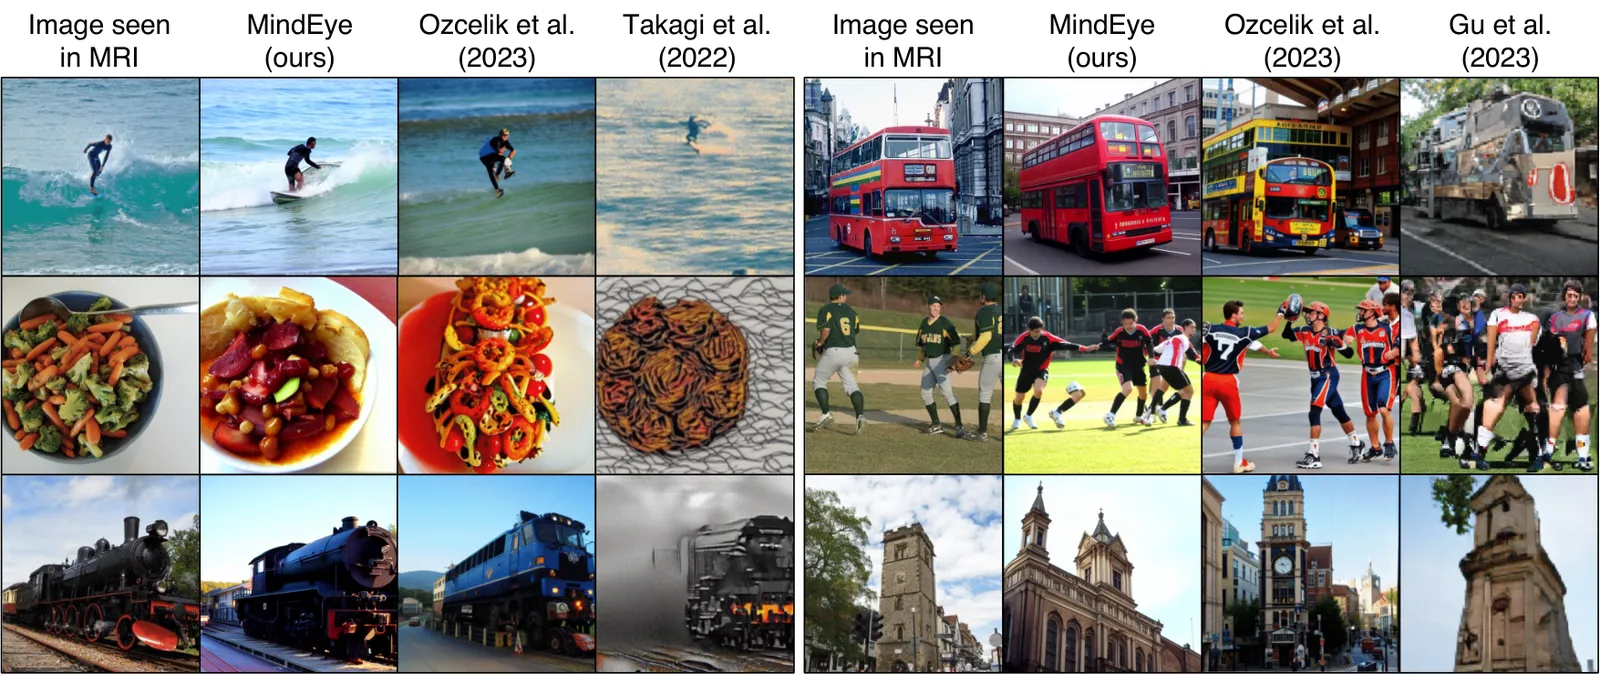
三个系统,各一段话说清
三篇论文解决的是同一个任务:被试躺在 fMRI 扫描仪里看自然图像,模型要回答两个问题之一,检索(到底看了哪张)或重建(画一张差不多的)。听起来是一件事,其实是两件事,这个领域最好的系统都把它们分开优化。
Brain Diffuser(Ozcelik 与 VanRullen,2023)走冻结管线路线:岭回归把脑体素映射到 Versatile Diffusion 的 VAE 潜变量得到低层初稿,另几组岭回归预测 CLIP 视觉和文本嵌入,预训练好的扩散模型负责生成。需要训练的只有线性探针,生成部分全部现成。
MindEye(Scotti 等,2023)走训练管线路线:9.4 亿参数残差 MLP 把体素映射进 CLIP ViT-L/14 空间,配两个并行子模块,对比学习投影头做检索、从头训练的扩散先验修补脑嵌入与图像嵌入之间的「模态鸿沟」。单张 A100 训练 18 小时以内。
MinD-Vis(Chen 等,2023)走训练配方路线:掩码自编码器以 0.75 掩码率在约 13.6 万段 fMRI 数据(HCP 加 GOD)上预训练,再微调一个双条件潜扩散模型。主打数字来自 GOD 数据集,不是 NSD。
关键数字
MindEye 的评测在相同 NSD 划分上重跑了 Brain Diffuser,所以下面这块是真正的同口径对比,不是从三篇互不相关的论文里抄数字。NSD,四名被试平均,982 张测试图。
| 方法 | PixCorr ↑ | SSIM ↑ | AlexNet(2) ↑ | AlexNet(5) ↑ | Inception ↑ | CLIP ↑ | 同口径? |
|---|---|---|---|---|---|---|---|
| MindEye | .309 | .323 | 94.7% | 97.8% | 93.8% | 94.1% | 是,同一 NSD 评测 |
| Brain Diffuser | .254 | .356 | 94.2% | 96.2% | 87.2% | 91.5% | 是,MindEye 重跑 |
| Takagi & Nishimoto | 未报 | 未报 | 83.0% | 83.0% | 76.0% | 77.0% | 是,同一 NSD 评测 |
| Gu et al. | .150 | .325 | 未报 | 未报 | 未报 | 未报 | 是,同一 NSD 评测 |
看行,别只看赢家。MindEye 六项赢五项。Brain Diffuser 赢的 SSIM 奖励像素网格对齐,这与它的设计一致:VDVAE 初稿路径保留低层版面,而不是合成看着合理的纹理。这正是两家的分野:MindEye 买语义正确,Brain Diffuser 买像素结构,哪个数字都不等于「综合画质」。
这些指标本身分工也不同:AlexNet(2)/(5) 与 Inception 把重建图喂给预训练分类器、问类别还在不在,测语义;PixCorr 做像素强度相关,测低层保真。一个模型可以一项很高、另一项明显失败,所以论文才一次报六个指标,只放最漂亮 demo 的解读都值得警惕。
检索任务,差距大到离谱
重建质量有争议,检索没有。NSD 上 300 个候选、随机率 0.3%:
| 方法 | 图像检索 ↑ | 脑检索 ↑ |
|---|---|---|
| MindEye | 93.6% | 90.1% |
| Brain Diffuser | 21.1% | 30.3% |
| Lin et al.(被试 1) | 11.0% | 49.0% |
MindEye 论文还报告被试 1 在完整 982 张测试集上 top-1 精确检索 93.2%。这是脑机解码报道里最被低估的事实:生成画面「更震撼」的系统,五次里有四次认不出原始刺激;检索 93%+ 的系统把生成只当作渲染步骤。标题写「AI 读懂你的大脑并画出你所见」时,先问它引的是哪张表。
被试 1 的低层子对比也值得知道:MindEye 低层管线 PixCorr .456、SSIM .493,对 Brain Diffuser 同被试的 .358、.437。四名被试的平均差距,反而低估了训练管线在采样最好被试上的领先幅度。
MinD-Vis 的数字,以及它为什么不在表里
MinD-Vis 论文里没有 NSD 数字,把它的结果塞进上表,正是这个领域排行榜失真的典型做法。它的基准是 GOD 与 BOLD5000:GOD 被试 3 的 100 选 1 top-1 准确率 0.212(同协议比 Ozcelik 等高 66%),FID 1.67,五次采样一致性 0.1736 ± 0.029。
MinD-Vis 贡献的不是可排名的数字,而是被后人普遍采用的配方。消融非常直白:去掉 SC-MBM 掩码预训练,准确率从 23.9% 崩到 2.6% 到 3.4%;只保留交叉注意力条件则掉到 15.6%。要复现这个领域的任何解码器,预训练阶段是最关键的部件,这是 MinD-Vis 的论点,不是 MindEye 或 Brain Diffuser 的。
怎么选
目标是认出看了什么 → MindEye。 300 候选、随机率 0.3% 下的 93.6% 是同口径实测,而且度量的只是「从已知刺激集里认出看过的图」,不是读想法。这个对比里没有对手,因为别人根本没为检索而设计。
要可复现的重建基线 → Brain Diffuser。 冻结生成器上的线性探针便宜、可解释,SSIM 领先也是真的。硬件有限、又想把每个部件看明白,从这里起步。
要训练配方 → MinD-Vis。 「没有掩码预训练就从 23.9% 掉到 2.6% 到 3.4%」是这个领域「怎么预训练比挂哪个扩散模型更重要」的最强单条证据。无论你最终搭哪个解码器,都该拿它当第一阶段。
目标是沟通辅助 → 以上都不是,去看 Brain2Qwerty。 Brain2Qwerty 从非侵入 MEG 解码打字,平均字符错误率 32%。信号可穿戴性是数量级的进步,离辅助沟通质量仍然很远,它才是「可落地一端到底走到哪了」的诚实参照。
局限与存疑
模型按人训练。 三家都是每个被试单独训一个模型。93.6% 背后是数小时个人扫描数据拟合出的模型,对陌生人五分钟扫描毫无意义。跨被试数字达到同等水平之前,「通用读心」的说法都应打折。
生成器承担了大量工作。 每个方法都以预训练图像模型为条件,Versatile Diffusion 或 Stable Diffusion 的 VAE 与先验。重建图继承生成器先验,所以信号很弱时输出也像合理照片。这不是作弊,是设计使然;但它意味着这些图是「在自然图像先验下与脑数据一致」,不是「那个人看到的东西」。
fMRI 是部署天花板。 三套系统都要扫描仪、数小时单人训练数据与实验室条件,没有一个比上面的 MEG 打字解码器更接近真实使用场景。
重建 demo 被物理学 cherry-pick。 语义分类器占优的指标体系下,论文自然挑出类别猜对的样例。诚实的评测是硬候选池下的检索数字,这也是本篇把它放在最前面讲的原因。
缺一个受控实验。 没有一篇论文在同一批被试、同算力下把三条管线都训一遍并同时报检索与重建。MindEye 重跑了 Brain Diffuser 但没有 MinD-Vis;MinD-Vis 根本没碰 NSD。在那项研究出现之前,用现有表格排「最强脑解码器」,排的都是部分证据。
常见问题
为什么 MindEye 检索 93.6%,Brain Diffuser 只有 21.1%?
目标不同。MindEye 专门训练对比学习子模块(BiMixCo 加 SoftCLIP)让脑嵌入具有区分度,把生成当作独立渲染问题;Brain Diffuser 在检索上零投入,岭回归探针直接面向重建潜变量。21.1% 不是缺陷:检索本来就不是 Brain Diffuser 的优化目标。
为什么对比表里没有 MinD-Vis?
MinD-Vis 用的是 GOD 和 BOLD5000,这两个早期数据集的刺激分布与协议都不同。它的 GOD 数字(100 选 1 top-1 0.212)无法和 NSD 的 PixCorr、SSIM 对比,论文本身也没有 NSD 结果。硬塞进表里,就是制造数据撑不起来的对比。
Brain Diffuser 的 SSIM 比 MindEye 高,说明它的重建图更好吗?
只在像素结构这一个轴上更好。SSIM 奖励网格级对齐,Brain Diffuser 的 VDVAE 初稿恰好保留这个;而 MindEye 的 PixCorr 和所有语义指标(AlexNet、Inception、CLIP)都领先,意味着它的重建更可靠地落在正确类别。对多数用途,「被试看的是哪类东西」,语义那一行才是要紧的。
想动手复现,先复现哪个?
Brain Diffuser:只有岭回归需要训练,其余冻结且预训练,普通硬件就能跑,每个部件都可检查。然后再把 MinD-Vis 的掩码预训练阶段加在扩散微调之前,MinD-Vis 自己的消融表明,准确率主要来自这一阶段。
这些系统能读想法、想象或梦吗?
不能。三家解码的都是被试此刻在扫描仪里观看的图像,用的是在该被试数小时数据上拟合的模型。没有一篇声称能解码想象、梦境或内心独白,检索数字描述的是从已知候选集里识别刺激,仅此而已。