
Mask R-CNN 到 SAM 2:分割模型对比
43.7 对 37.2,Mask2Former 领先 Mask R-CNN;SAM 零样本 46.5 对 51.0;SAM 2 视频 76.8 J&F 超 XMem 60.1,快 6 倍。
一句话结论
这四个模型不是同一张榜上的四个名次,它们解的是三类不同的问题。Mask R-CNN 和 Mask2Former 是有监督模型:在你的数据集上、按你的类别训练,追求平均精度。SAM 是基础模型:给一个点或框作为提示,它在没见过的图像上直接输出掩码,完全不需要微调。SAM 2 把同样的可提示思路带进了视频,靠流式记忆跨帧传播。所以真正该问的不是”谁的 AP 最高”,而是”你要解哪个问题”:是能标注的固定类别,还是任意图像、任意物体。
每个方法真正改了什么
Mask R-CNN(2017)在 Faster R-CNN 检测框架上加了一个小的掩码头:对每个候选框,一个小型全卷积网络预测二值掩码,RoIAlign 修掉了旧 RoIPooling 把框对齐到特征网格时产生的错位。它是”先检测、再分割”的经典范式,其后代统治 COCO 榜单多年。
Mask2Former(2021)属于另一个家族:掩码分类。它不从检测框推导掩码,而是直接预测一组二值掩码,用 Transformer 解码器给每个掩码分配类别标签,同一套架构统一处理全景、实例、语义三种分割。它的关键设计是掩码注意力(masked attention):解码器每层的交叉注意力只关注上一层预测掩码的前景区域,查询只盯着自己的物体看局部细节,而不是把注意力摊到整幅图上。结果是一个通吃三种任务的通用模型,而且每种都超过专用架构。
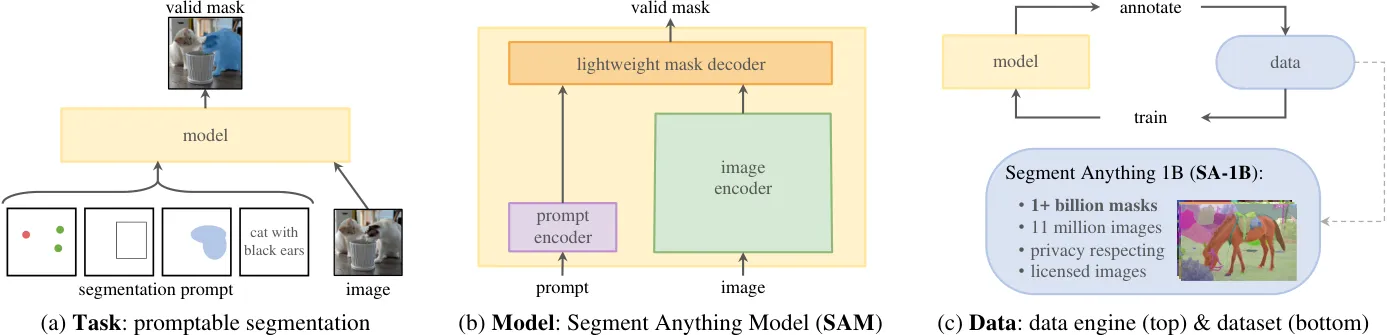
SAM(2023)改的是任务本身。Meta 定义了”可提示分割”任务:给定任意提示,点、框或掩码,返回提示所指物体的有效掩码。架构上拆成一个每图只跑一次的重型图像编码器和一个轻量掩码解码器,解码器约 50 毫秒就能响应一个提示,交互使用很顺手。SAM 在 SA-1B 上训练,那是模型在环的数据引擎收集的 11 亿掩码、1100 万张图像,掩码数量是当时最大分割数据集的约 400 倍。它从一开始就不是为赢 COCO 训练的,而是为”分割一切”,包括没人标过类别的物体。
SAM 2(2024)把这份合同推广到视频。一帧上的提示必须传到所有帧,物体在动、会遮挡、还会再出现,于是架构加了记忆编码器、记忆库和记忆注意力,让当前帧能读取过去帧和提示的缓存特征。数据引擎产出了 SA-V:50.9K 段视频、642.6K 个掩码序列,标注掩码数量是此前任何视频分割数据集的 53 倍。SAM 2 是单一模型,同时做可提示图像分割、可提示视频分割和零样本视频目标分割。
U-Net(2015)和 DeepLab 是整个故事的上游:U-Net 证明带跳跃连接的收缩扩展式卷积网络可以只用极少图像端到端训练,以 92.03 IoU 赢得 ISBI 细胞追踪挑战,第二名只有 83;DeepLab 引入空洞卷积和空洞空间金字塔池化做稠密预测,PASCAL VOC 2012 测试集 79.7 mIoU。U-Net 是所有编码器解码器分割器的祖先,它确立的逐像素分类范式恰好是 Mask2Former 用掩码分类范式替代掉的东西。
关键数字
| 测量项 | Mask R-CNN | Mask2Former | SAM | SAM 2 | 设置与出处 | 同口径? |
|---|---|---|---|---|---|---|
| COCO 实例 val2017 AP,ResNet-50 | 37.2 | 43.7 | n/a | n/a | Mask2Former 论文表 2,36 对 50 epoch | 是,同一张表,均只用 COCO train2017 训练 |
| COCO 实例 val2017 AP,ResNet-50,长程配方 | 42.5 | 43.7 | n/a | n/a | Mask2Former 表 2,Mask R-CNN 用 400 epoch 多尺度配方 | 是 |
| COCO 实例 val2017 AP,ResNet-101 | 38.6 | 44.2 | n/a | n/a | Mask2Former 表 2 | 是 |
| COCO 实例 val2017 边界质量 AP^boundary,ResNet-50 | 23.1 | 30.6 | n/a | n/a | Mask2Former 表 2 | 是 |
| COCO 实例 val2017 AP,最强模型 | n/a | 50.1(Swin-L) | n/a | n/a | Mask2Former 表 2,同表还有 QueryInst 48.9 | 是 |
| COCO 全景 test-dev PQ,Swin-L | n/a | 58.3 | n/a | n/a | Mask2Former 表 II,同表 MaskFormer 55.4、K-Net 55.2 | 是 |
| ADE20K 语义 val mIoU,Swin-L | n/a | 57.7 | n/a | n/a | Mask2Former 表 3,同表 MaskFormer 55.6 | 是 |
| 零样本 COCO 实例 AP,给框提示 | n/a | n/a | 46.5 | n/a | SAM 论文表 5,SAM 拿 ViTDet-H 的框做提示 | 是,同一评测;有监督 ViTDet-H 为 51.0 |
| 零样本边缘检测 ODS,BSDS500 | n/a | n/a | .768 | n/a | SAM 论文表 3,在 BSDS 上训练的 HED 为 .788 | 是 |
| 零样本视频目标分割,SA-V val J&F | n/a | n/a | n/a | 76.8(Hiera-B+)/ 77.9(Hiera-L) | SAM 2 论文零样本半监督 VOS 表,同表 XMem 60.1、Cutie-base+ 61.3 | 是 |
| 交互式图像速度,1 点击 23 数据集平均 | n/a | n/a | 基准 | 精度更高且快约 6 倍(Hiera-B+) | SAM 2 论文表 15,对比 SAM ViT-H | 是 |
“Mask2Former 赢 Mask R-CNN”的论据集中在前四行:它们来自 Mask2Former 论文的同一张训练表,作者在写明的协议下(只用 COCO train2017、单尺度推理)重训并重评了 Mask R-CNN 基线,是这一领域最接近受控对比的东西。SAM 的几行传递的反而是另一个信息:SAM 的零样本数字被刻意放进与全监督专用模型相同的评测里,结果接近但普遍略低,而这正是重点,SAM 从没见过目标数据。
为什么掩码分类胜过了”先检测再分割”
Mask R-CNN 的流程是串行的:先找框,再在框内分割。检测错误直接封顶掩码质量,漏一个框就漏一个掩码,掩码头也只能看到框内的特征。Mask2Former 的查询则竞争着解释整幅图,每个查询可以在任何位置输出任意形状的掩码,掩码质量与框质量解耦。让它真正起效的是那个细节:交叉注意力被限制在上一层预测的掩码区域内,查询相当于自动放大到自己负责的物体上。
幅度就写在 Mask2Former 论文的表 2 里。ResNet-50 上,标准 36 epoch 的 Mask R-CNN 到 37.2 AP;同骨干的 Mask2Former 用 50 epoch 到 43.7。即使把 Mask R-CNN 推到 400 epoch、加多尺度增广拉到 42.5,默认配方的 Mask2Former 仍以 43.7 领先,边界质量也更好,长程配方对 28.0 AP^boundary,36 epoch 对 23.1。同一套架构还顶三种任务:Swin-L 档在 COCO 全景到 57.8 PQ、ADE20K 语义到 57.7 mIoU。这就是论文把收益表述为”研究工作量降到三分之一”的原因:一个模型顶替三个专用模型。
SAM 玩的是另一种游戏
SAM 论文里有张表,看上去像败仗,其实是全部论点。COCO 实例分割上,拿 ViTDet-H 级别的框提示 SAM,零样本 46.5 AP;而 ViTDet-H 用自己有监督的检测流水线,51.0。SAM 落后 4.5 个点,这 4.5 个点就是整个故事:一个从没在 COCO 上训练过的模型,追上了专精模型的大部分差距。边缘检测行是同样的形状:BSDS500 上零样本 ODS 0.768,对比在 BSDS 上训练的 HED 0.788。目标提议也一样:SAM 掩码 AR@1000 为 59.3,ViTDet-H 为 63.0。
换来这 4.5 个点的代价,是取消所有标注要求。如果你的应用涉及 COCO 80 类以外的东西,医学影像、卫星场景、工业零件,SAM 的零样本掩码点一下就出来,单次提示约 50 毫秒。Mask R-CNN 和 Mask2Former 精度更高,但只覆盖你付费标注过的类别体系。它们回答的是不同的问题,所以”SAM 取代 Mask R-CNN”式的标题在两个方向上都误导。
SAM 2 把合同推广到视频
视频打破了 SAM 的隐含假设:图只处理一次。被追踪的物体会移动、遮挡、再出现,于是 SAM 2 加了记忆机制:过去的帧和提示经记忆编码器压缩进记忆库,记忆注意力让当前帧在预测掩码前先读取这些缓存。结果写在论文的零样本视频目标分割表里,幅度之大是图像表无法相比的:SA-V val 上,专用半监督 VOS 模型 XMem 到 60.1 J&F,Cutie-base+ 到 61.3,而零样本、并非为该任务特化的 SAM 2,Hiera-B+ 到 76.8,Hiera-L 到 77.9。
图像侧同时也在进步。按 SAM 2 论文表 15,只用图像训练的 SAM 2 Hiera-B+ 在 SAM 的 23 数据集套件上,单次点击分割精度超过 SAM ViT-H,速度约快 6 倍;混入视频数据训练后,23 数据集平均升到 61.4。SAM 2 还接受图像提示并跨帧传播,图文混合流水线不再需要两个不相干的模型。
怎么选
- 类别固定、有标注数据、有精度指标要达:Mask2Former。 同口径对照表没有歧义:ResNet-50 上 43.7 对 37.2,而且一套架构覆盖实例、全景、语义三种分割,需求漂移也不用换模型。
- 需要边界框作为交付物,或整条流水线以检测为中心:Mask R-CNN。 掩码从框流水线里免费得到,实现简单,每个 CV 代码库都有现成版本。裸精度落后 Mask2Former,但经典的检测加分割产品里它仍是务实的默认项。
- 目标不在任何数据集里、标注预算接近零、或有人坐在回路里点击:SAM。 接受它在任何给定基准上比微调专精模型低几个点的事实;你拿这个差距换零训练。
- 输入是视频,或图像视频混合:SAM 2。 零样本视频数字是本篇对比里最大的单边差距:SA-V val 76.8 J&F 对同表最强专用基线 60.1;B+ 档还保持 SAM 级图像能力并提速约 6 倍。
局限与存疑
上表几乎每个跨模型格子都是”放在一起的说法”,不是正面交锋。最干净的行来自 Mask2Former 论文自己重训的 Mask R-CNN,以及 SAM 论文同评测的零样本表,但即便这些,训练制度也不同:Swin-L 档的 Mask2Former 用了 ImageNet-22K 骨干预训练,而它的 ResNet-50 行是只拿 COCO 从零训的。SAM 的数字按设计就是拿零样本模型对比有监督专精,所以”接近 ViTDet”不等于可以跳过自有分布上的评测;SAM 论文自己就记录了它在细小结构(如文字)和歧义提示(多个掩码预测任意取一)上的弱点。类别不可知的掩码也不是流水线终点:SAM 不给类别标签,下游总得有个检测器或分类器接着跑。SAM 2 的视频记忆是有限的,长视频、重遮挡下精度会衰减,而且它在 SA-V val 上的领先部分来自训练了与 SA-V 相近的数据,“零样本”指的是”未在基准上微调”,不是”没用过相关训练数据”。最后,这里所有数字都是 2015 到 2024 年的快照;该部署哪个,要在你自己的数据上跑一遍基准再定。
常见问题
COCO 上 Mask R-CNN 和 Mask2Former 谁强?
Mask2Former,受控对比的每一行都赢。Mask2Former 论文表 2 里,ResNet-50 的 Mask2Former 在 COCO val2017 到 43.7 实例 AP,同骨干标准 36 epoch 的 Mask R-CNN 是 37.2;就算 Mask R-CNN 用上 400 epoch 多尺度配方也只有 42.5。ResNet-101 档差距是 44.2 对 38.6,边界质量指标在每个骨干档位也都是 Mask2Former 赢。
SAM 能替代 Mask R-CNN 或 Mask2Former 吗?
只有在你的任务容忍”类别不可知的掩码”和略低的精度时才可以。COCO 实例分割上,拿 ViTDet-H 的框提示 SAM,零样本 46.5 AP;有监督的 ViTDet-H 是 51.0,在 COCO 上训练的 Mask2Former 是 50.1。SAM 的优势是完全不需要训练数据、覆盖任意物体,所以类别不在任何公开数据集里、或有人交互点击的场景它赢;在固定、已标注的类别体系上追极致精度时它输。
SAM 2 比 SAM 强吗?
视频上,碾压级:SA-V val 零样本,SAM 2 的 Hiera-B+ 到 76.8 J&F,而专用 XMem 只有 60.1,况且 SAM 根本没有原生视频能力。图像上,SAM 2 的 Hiera-B+ 在 23 数据集平均的单次点击分割精度超过 SAM ViT-H,速度还快约 6 倍,混入视频训练后平均进一步升到 61.4。SAM 2 还接受图像提示并跨帧传播,图文混合工作流下没有理由继续留 SAM。
为什么 Mask2Former 能用一套架构做三种任务?
因为它把每种任务都统一成掩码分类:预测一组二值掩码,给每个掩码分配类别标签,“实例”和”语义”只是同一组掩码上不同的标签约定。让它起效的是掩码注意力:Transformer 解码器每层只在上一层预测掩码的内部做注意力,查询在局部精修自己的物体。论文报告同一架构在 Swin-L 档达到 COCO 实例 50.1 AP、COCO 全景 57.8 PQ、ADE20K 语义 57.7 mIoU。
今天的 U-Net 和 DeepLab 还有什么位置?
各自的小众领域里仍是正确的起点。U-Net 的编码器解码器加跳跃连接,至今仍是医学、科研小数据场景的默认架构,它在 2015 年 ISBI 细胞追踪挑战上以 92.03 IoU 夺冠,第二名在同等的极小数据制度下只有 83。DeepLab 的空洞卷积和 ASPP 至今仍是稠密预测流水线的标准组件,79.7 的 VOC 2012 mIoU 定义了 Transformer 之前的最优水平。它们在 COCO AP 上无法和 Mask2Former 竞争,但训练数据需求小得多,机制也简单得多。