
RHO 和 Harness-1 的对比:让 harness 干活的两种路线
RHO 事后从无标注轨迹调优 harness;Harness-1 事前设计 harness 让 RL 只学语义判断。同一前提,两个问题,全部用论文原始数字。
共同的前提,分岔的路
两篇论文从同一个观察出发:LLM 智能体的能力,至少有一半来自 harness,也就是包在模型外面的提示词、技能、工具、记忆和控制流。Code as Agent Harness 这篇综述把现状梳理得很清楚:智能体的指令、工具脚本乃至控制流本身都已经是代码 artifact,可以检查、可以版本化、可以改。一旦 harness 成了看得见的工件,两条研究路线就打开了,而 RHO 和 Harness-1 分别是这两条路最干净的公开样本。
RHO 把 harness 当成优化对象:你已经有一个在跑的智能体,想让它随时间变好,但没人能提供匹配未来任务分布的标注验证集。Harness-1 把 harness 当成可训练性的前提:你在设计一个要用 RL 训练的智能体,希望梯度下降把容量花在判断上,而不是花在记账上。一个在事后调,一个在事前设计。选哪条,取决于你真正的问题是哪个。
关键数字
| 维度 | RHO | Harness-1 | 同口径? |
|---|---|---|---|
| 改动对象 | 固定 Codex 智能体外层的技能、工具与指令 | 20B 策略被要求做的事;杂务挪进环境 | 否,一个调优、一个重构 |
| 训练信号 | 对历史任务重采样 rollout,自验证 + 自一致诊断,成对自偏好排序 | 八个检索基准上的 curated recall 奖励做 RL | 否 |
| 需要标注 | 完全不需要 | 训练时要金标支撑证据来算 recall | 否 |
| 头条结果 | SWE-Bench Pro 一轮 0.59 → 0.78(+19 分) | 平均 curated recall 0.730,领先最强开源搜索子智能体 +11.4 分 | 基准不可互比 |
| 其他基准 | Terminal-Bench 2:0.71 → 0.76(+5);GAIA-2:0.29 → 0.37(+8) | 提升最大的是分布外迁移基准 | n/a |
| 对比最强替代方案 | 同预算下单轮 Meta-Harness 只有 0.62(用标注);Meta-Harness 跑到 10 轮、约 3 倍算力才到 0.80 | 领先次强开源子智能体 +11.4 分;“与前沿搜索器持平”是未钉死的软主张 | 各自论文内部成立 |
| 优化成本 | 每轮 103 次 agent 调用,Meta-Harness 单轮是 41 次 | 手工 harness:候选池、重要性标签、去重、预算渲染 | 否 |
| 决定性消融 | 去掉自一致:0.56,跌破 0.59 的原始基线;去掉自验证:0.70;不做诊断:0.60 | 论文没有 harness 与策略贡献分离的消融,增益可能部分来自调得好的脚手架 | 仅 RHO 有 |
读这张表时先看哪些行可比、哪些不可比。RHO 的全部数字来自 SWE 类智能体基准、backbone 是冻结的 Codex;Harness-1 的全部数字来自检索基准、模型是训练出来的 20B。0.78 和 0.730 测的是不同任务上的不同指标,本文从头到尾不把它们放在同一根轴上。
RHO:把现成的 harness 调优
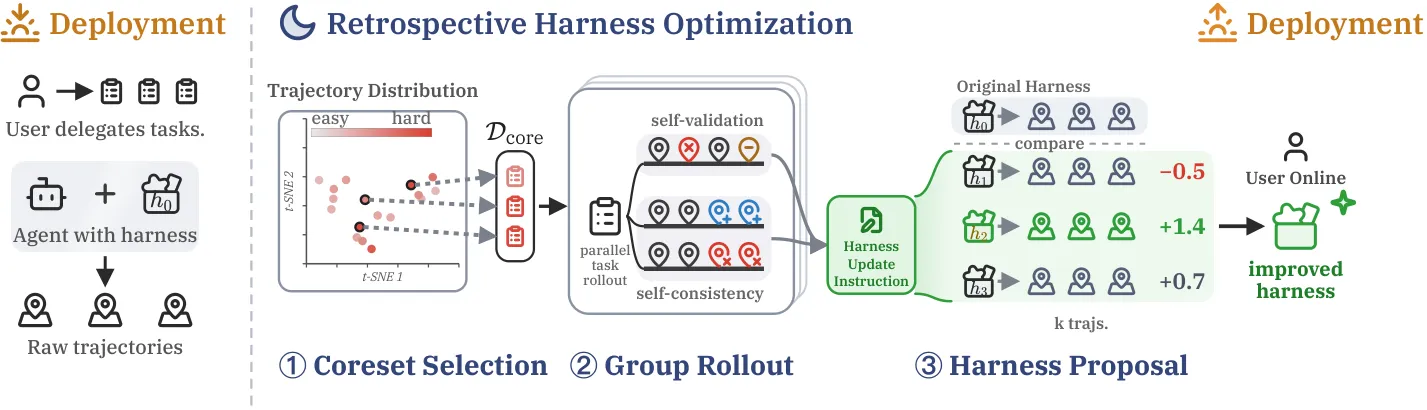
RHO 面对的是更常见的处境:智能体上线了,轨迹在积累,但没人有标注。它的赌注是:在没有评分器时,智能体对自己 rollout 的判断是质量的可用代理。流程分三步:用行列式点过程(DPP)从历史任务里选一个既难又分散的小核心集;把每个任务并行重解若干次,提取两个免标签的诊断信号:自验证看单条轨迹里智能体自己的哪些检查失败了,自一致看同一任务的并行 rollout 之间分歧在哪;再用诊断驱动 best-of-N 的候选 harness 提案,由成对自偏好选出上线的那一个。
要紧的结果:一轮就把 SWE-Bench Pro 从 0.59 提到 0.78,而且学出来的 harness 是具体可调试的工具,比如一个能找到默认路径之外 Go 工具链的 check_build_and_lint 脚本。这不是抽象的提示词润色。
论文自己的两个消融警告值得认真对待。其一,自一致在扛大头:去掉它,SWE-Bench Pro 掉到 0.56,比 0.59 的原始基线还低,也就是说退化的版本不是在帮倒忙之前止步,而是 actively 有害。其二,0.78 是最有利的单点:同一方法在 Terminal-Bench 2 只 +5、GAIA-2 只 +8;且自偏好是智能体给自己打分,可能偏爱”模型喜欢”而不是”能泛化”的改法,选出的候选并不总是真正的最高分。RHO 还为免标签付了推理成本:每轮 103 次 agent 调用,而单轮 Meta-Harness 是 41 次。
Harness-1:把 harness 设计成 RL 只学判断
Harness-1 的出发点是另一种不满:RL 是用来学记账的,太浪费。普通搜索智能体让同一个策略在长 transcript 上同时干两份活:做真正难的语义决策(查什么、留哪篇文档),以及记无聊的、可恢复的账(哪些约束还开着、五十篇段落里哪些值得留)。论文的 harness 把第二份活全部挪进环境:候选池、带重要性标签的精选集、证据链接、验证记录、压缩后的观测、按 token 预算渲染上下文。策略只保留四件事:搜什么、留什么、验什么、什么时候停。
奖励也因此可以直指目标:论文用 curated recall(金标支撑证据里有多大比例进了智能体的精选集)而不是只看最终答案准确率;对输出要喂给下游阅读器的检索子智能体,这是更诚实的目标。报告的结果:八个横跨网页、金融、专利和多跳问答的检索基准上平均 curated recall 0.730,领先最强开源搜索子智能体 +11.4 分,且提升最大的是分布外迁移基准,这正是”学到的是可迁移的搜索技能而不是背题”的证据。
警告和 RHO 对称。curated recall 是检索侧指标:召回高的子智能体照样可能喂给一个弱的阅读器,端到端收益没有保证。“与更大的前沿搜索器持平”是个软主张,摘要没有钉死是哪个前沿模型、差多少。而且 harness 本身是手工工程的,没有 harness 与策略贡献分离的消融,增益可能有一部分来自调得好的脚手架而非 RL 本身;维护这套有状态 harness 是实打实的工程开销,普通 transcript 策略没有这笔账。
怎么选
- **已部署的智能体、有历史轨迹、没标注:**选 RHO。它的全部意义就是从你已有的数据里免标签提升,+19 分说明一轮就够见效。
- **从零训练搜索/检索智能体、事前付得起脚手架:**先按 Harness-1 的思路把杂务外置。策略花在去重上的每个参数,都是没有花在判断上的参数,迁移结果就是回报。
- **智能体总在可恢复的账上出错(上下文错乱、丢了约束):**这是 Harness-1 的诊断,RHO 治不了,因为回溯调优改的是 harness 的文本,不改状态放哪。
- **失败模式没有标签就难诊断:**RHO 的自一致信号正是为此而生,但记住消融警告:跑 best-of-N,绝不上线单个提案。
- **两个都做:**它们可组合。Harness-1 式的外置 harness 仍由可检查的 artifact 组成,之后完全可以用 RHO 式回路从生产轨迹里继续调。
局限与存疑
不存在把两种方法放到同一任务上的受控实验,因为它们本来 targeting 不同任务:RHO 测在 SWE 和通用智能体基准、backbone 是冻结的前沿模型;Harness-1 测在检索、模型是训练出来的 20B。状态外置的脚手架能否扛住 RHO 式的回溯编辑,RHO 的自偏好在训练过的 20B 检索策略上还能不能给出有效诊断,两篇论文都没碰。把两者当作碰巧共享同一个前提(“harness 是杠杆点”)的两个问题的两个答案,是最诚实的读法。
常见问题
RHO 和 Harness-1 的核心区别是什么?
RHO 在部署后从过去无标注轨迹中优化现有 harness,信号是自一致和成对自偏好,模型不动;Harness-1 在训练前设计 harness,把记账杂务挪进环境,让 RL 只优化语义决策。一个在事后调,一个塑造事前架构。
RHO 需要真值标签吗?
不需要。它用智能体自己算得出来的两个信号替代标注验证集:自验证(单条轨迹里失败的自查)和自一致(同一任务并行 rollout 的分歧)。SWE-Bench Pro 从 0.59 到 0.78 的提升全程无外部评分,代价是每轮 103 次 agent 调用。
Harness-1 说的”状态外置 harness”是什么意思?
把日常、可恢复的状态管理(候选池、去重、验证记录、按预算渲染上下文)从策略里挪到环境侧的代码中。20B 策略只决定搜什么、留什么、验什么、何时停,RL 训练的对象也只有这四件事。
RHO 和 Harness-1 能组合吗?
概念上可以,两篇论文都没有排除。Harness-1 式 harness 由可检查的 artifact 组成,之后接 RHO 式回路从生产轨迹继续调,路径是通的。但没有任何一篇测过这个组合,这是推断,不是实测结论。
哪种路线对弱模型可行?
RHO 明确假设 base model 足够强:它的诊断依赖智能体的 rollout “有信息量地”分歧,论文没测弱模型边界。Harness-1 的 20B 策略是在 harness 里训练出来的,结果不依赖前沿 backbone,但依赖手工脚手架和 curated recall 训练信号。