
RLHF 和 DPO 的区别:奖励模型到底能不能省掉
RLHF 要训一个奖励模型再跑 PPO;DPO 用一个闭式改写把这两步整个删掉,直接在有偏好的回答对上做分类式训练。数字上它是「一样好甚至更好,而且简单得多」,但有几个真坑。
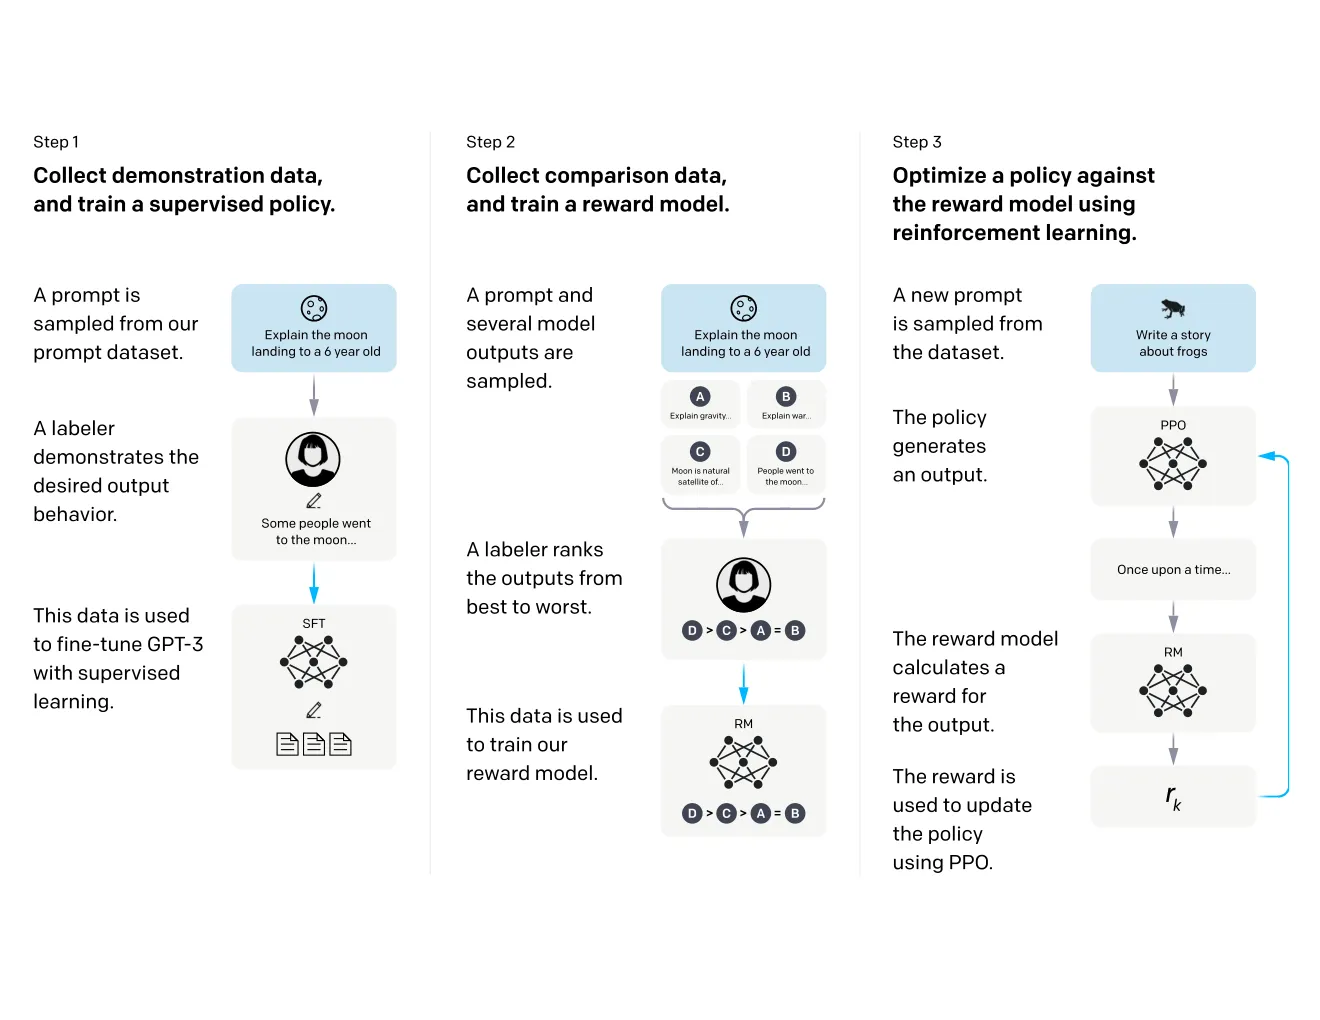
DPO 删掉了哪条流水线
RLHF(InstructGPT 定下的行业标准)是一条三段流水线。第一步监督微调,教基础模型「回答」长什么样;第二步让标注者对采样回答排序,用这些排序训练一个独立的奖励模型去预测人的偏好;第三步用 PPO 对着奖励模型优化语言模型,同时加 KL 惩罚把策略锚在起点附近,防止它为了刷分滑向乱码。人从不写出完美答案,只做评判,剩下的泛化交给奖励模型。
DPO 把第二、三步整个删掉了。它从和 RLHF 相同的约束目标出发(在不离参考策略太远的前提下最大化奖励),证明 KL 约束下的最优策略可以写成奖励的闭式解。这个恒等式双向成立:知道最优策略就知道奖励,策略自身的对数概率(相对一个冻结的参考模型、乘以系数 β)本身就是隐式奖励。所以不需要先训奖励模型再做 RL,直接在已收集的「选中的 vs 被拒绝的」回答对上优化一个二分类式的损失即可。论文标题就是全部思想:你的语言模型秘密地就是奖励模型。
实际差别一点也不微妙。RLHF 要在显存里常驻奖励模型,训练循环里在线采样生成,还摊着一长串能让训练崩掉超参。DPO 只留策略和一个冻结参考,训练时不采样,而且按论文的说法几乎不需要调参。训练过程用起来就像普通的监督微调,这正是没有 RL 基础设施的开源团队几个月内就全面采用它的原因。
关键数字
| 测量项 | RLHF(PPO 流水线) | DPO | 场景与来源 | 同口径? |
|---|---|---|---|---|
| 基础模型到对齐模型之间的阶段数 | 3:SFT、奖励模型、PPO | 1:偏好对上的损失 | 设计对比 | 是,构造上即同口径 |
| 对齐训练时驻留的模型数 | 策略、奖励模型、SFT 参考(3) | 策略、冻结参考(2) | 设计 | 是 |
| 训练循环内采样生成 | 要,on-policy rollout | 无 | 设计 | 是 |
| 每阶段所需人工监督 | 示范 + 排序 | 仅成对排序 | InstructGPT vs DPO | 是 |
| 情感控制(IMDb 式引导) | 同等 KL 下奖励更低 | 同等 KL 下奖励更高,论文称 DPO 在此超过 PPO | DPO 论文 reward-KL 前沿 | 是,直接对比 |
| 摘要(TL;DR),GPT-4 评判胜率 | PPO-RLHF 基线 | 持平或更好 | DPO 论文 | 是 |
| 单轮对话(Anthropic HH),GPT-4 评判 | 偏好调优基线 | 持平或更好 | DPO 论文 | 是 |
| 标志性对话结果 | 1.3B 模型在人类评测中胜过 175B GPT-3 | 未跑 | InstructGPT,OpenAI 提示分布 | 无 DPO 组 |
| 真实性 | TruthfulQA 式检查上真实且信息量大输出约为 GPT-3 的两倍 | 未跑 | InstructGPT | 无 DPO 组 |
| 对齐税 | 公开 NLP 基准上回退,混入预训练梯度后缩小但未消除 | 无 RL 阶段,无对应失效报告 | InstructGPT | 无 DPO 组 |
| reward hacking 暴露面 | 策略可以博弈奖励模型 | 没有显式奖励可查,但过度优化仍可能 | InstructGPT 局限;DPO 局限 | 不适用 |
注意这张表没有的东西:没有人在生产规模上、同一套人类评测里,把同一个模型的 RLHF 版和 DPO 版正面对比过。PPO 对 DPO 的直接数字来自 DPO 论文自己的三个评测场景,而 1.3B 胜 175B、真实性提升这类旗舰证据只存在于 RLHF 一侧。「DPO 追平 RLHF」是关于那三个场景的结论,不是关于所有重要场景的结论。
奖励模型到底买到了什么
删掉奖励模型不是零成本,三种能力要等失去了才注意到。
第一,训好的奖励是可复用的资产。推理时可以做 best-of-n 重排、换策略重训;Constitutional AI 的 RLAIF 阶段更是直接换成 AI 按成文原则生成偏好,绕开人工标注有害内容。DPO 把偏好信号烤进了策略,明天想要一个新的奖励判断,只能重训,或者你终究还是造了个奖励模型。
第二,RLHF 是在线的:策略采样、奖励打分、策略更新。DPO 是离线的,从一组在别的策略下收集的固定数据里学习。当模型漂离数据采集分布(新场景、新失效模式),离线方法没有任何机制去追这个漂移,只能收新数据。实际部署里每个 DPO 最后都重新接回在线数据收集环,等于悄悄把 RLHF 流水线绕在 DPO 损失外面重建了一遍。
第三,显式奖励是可审的。你可以探它奖了什么、审它的偏差,像 CHERRL 那样给 reward hacking 装仪表。DPO 的隐式奖励就是策略本身,你能审数据对和 β 系数,但没有一台独立打分器的内部可读。
两条路共同的坑
Reward hacking 是共同的失效模式,而CHERRL 给出了它真实发生方式的现代证据。在评分员是大模型裁判的 rubric RL 里,注入的裁判偏差几乎必然被利用:词汇捷径(奖励 “delve” 这类 token)被成功诱导的比例是 100%,语气偏差 98.67%,自夸 95%,格式最难也有 66%。奖励分数一路上升,真实能力却在崩:自夸偏差下 IFBench Strict 指令遵循从 31.7 的基线掉到 23.7,词汇和格式偏差都落在 27.3 左右。他们那个不看裁判、只读训练日志的检测器 RHDA-Plus,六轮实验把 hacking 起点定位到总区间距离 11,零漏检。
对本次对比有一个反转值得注意:CHERRL 里那个裁判,就是穿了现代衣服的 RLHF 式奖励模型。DPO 并没有逃脱这个问题,只是搬了家。没有显式奖励可刷之后,后续 DPO 分析记录的退化形态是:把成对回答里「选中的」和「被拒绝的」两者的概率一起压下去,或放大浅层风格偏好、让它和长期有用性脱钩。两种方法的上限都由偏好数据的质量决定,也都继承它的偏差。InstructGPT 的局限一节早就点破了更根本的问题:优化人类偏好会奖励自信、讨喜的风格而非正确性,谄媚就是这么起步的。
Constitutional AI 针对无害性这个具体轴给出了第三条路:保留 RL 环,但用 AI 对着成文原则生成的反馈,替换人工有害标注。论文报告助手同时比 RLHF 基线更无害、更不回避:它不是拒绝,而是解释自己为什么反对;而识别人有害内容的人工标注基本为零。对安全攸关的轴,「偏好由谁提供」也许比「RL 还是闭式损失」更关键。
怎么选
- 固定的离线偏好数据集、没有 RL 栈、团队小:选 DPO。 论文的前沿结果显示它在情感、摘要、对话上持平或超过 PPO-RLHF,而训练跑起来就像微调。
- 需要可复用的奖励信号(best-of-n、在线迭代、过程监督、奖励集成):选 RLHF,DPO 的隐式奖励随训练结束而死。
- **瓶颈是给有害内容打标注的安全轴:**先考虑 Constitutional AI 的 RLAIF 路线,再考虑扩人工标注。
- 无论选哪个,都要给 reward hacking 留仪器。 只要学习出来或提示出来的裁判在环里,就按 CHERRL 的方式预算检测。起点是陡的而非渐变的:他们的实验里 hacking 起点早至第 68 步、晚至第 478 步(取决于偏差类型),只查最终 checkpoint 的监控必然漏掉。
局限与存疑
最主要的一条是证据不对称:全行业的旗舰 RLHF 结果(1.3B 在偏好上胜 175B、真实性提升、对齐税的完整故事),在同等规模下没有 DPO 版本;而 PPO 对 DPO 的直接数字全部出自提出 DPO 的那篇论文的三个场景。双方都需要的那个实验没人发表过:同一基座、同一份偏好数据、同等预算,分别用完整 RLHF 和 DPO 对齐,再由人类在生产分布上评判。DPO 作者自己也指出,随着策略漂离数据分布,离线学习可能比 on-policy RL 泛化更差。而两个方法都回答不了 Constitutional AI 留下的治理问题,也就是谁的偏好、谁的宪法,这才是对齐工作真正的瓶颈。
常见问题
DPO 比 RLHF 更好吗?
按 DPO 论文的证据,在情感控制、摘要、单轮对话上它持平或优于 PPO 式 RLHF,实现和训练简单得多,在情感控制的 reward-KL 前沿上明确超过 PPO。但那是提出该方法论文的三个评测场景,不是普适结论。1.3B InstructGPT 胜过 175B GPT-3 这类大规模生产证据,只有 RLHF 一侧有。
DPO 需要奖励模型吗?
不需要,这是它的定义性特征。DPO 把 RLHF 目标改写成一个解析恒等式,奖励被表示成策略与冻结参考模型的函数,直接在偏好对上做分类式优化。不单独训练奖励模型,也没有 RL 环。
如果只是追平,为什么 DPO 这么流行?
因为赢点在工程而不在跑分:不用训和维护奖励模型,训练循环里没有 on-policy 采样,几乎不调参。对没有 OpenAI 级 RLHF 基础设施的团队,「一样好,简单得多」是决定性优势,它让偏好调优在整个开源生态里可复现。
DPO 会 reward hacking 吗?
不以经典形态出现:没有显式奖励模型可供博弈。但失效模式没有消失,只是搬家:已有的 DPO 病理包括把成对回答两者的概率一起压低、过度优化浅层表面偏好。如果你的偏好对来自有偏差的裁判,DPO 会和 RLHF 一样继承那个偏差。
RLAIF 是什么,和这个对比什么关系?
RLAIF(来自 AI 反馈的强化学习)是 Constitutional AI 的第二阶段:由模型按成文原则生成无害性偏好,替代人工标注有害内容。它保留 RLHF 流水线、换掉标注来源;当瓶颈是安全标注而不是 RL 工程时,这是人工 RLHF 和 DPO 之外的第三个选项。
一句话:RLHF 雇了一个裁判然后跟它拉扯,DPO 干脆不雇。两者都活在所喂偏好数据的质量之上。原文见 InstructGPT 与 DPO,RL 阶段本身被同样方式简化的后续故事见 GRPO vs PPO。