
Sentence-BERT、SimCSE、E5 对比:同口径 STS 数字说话
SBERT 把 1 万句相似从 65 小时缩到 5 秒;SimCSE 用 dropout 造正样本对,无监督 76.25、有监督 81.57;E5 零样本在 56 个数据集上首超 BM25。
一句话结论
这三篇论文相隔三年,回答的是句向量三个不同的瓶颈,彼此几乎不在同一张榜单上竞争。Sentence-BERT(2019)解决的是工程问题:cross-encoder 的 BERT 要两句一起读、每对都跑一次前向,1 万句里找最相似的一对要约 5000 万次推理、V100 上约 65 小时;SBERT 把每句独立编码成向量,1 万次编码约 5 秒,之后点积或余弦随便比。SimCSE(2021)解决的是数据问题:它不手工造增广,而是把同一句子过两遍同一个 encoder,靠 dropout 每次随机屏蔽不同激活得到两个略有差异的向量当正样本对,完全无标注就把 BERT-base 在 7 个 STS 任务上的平均 Spearman 从 72.05 拉到 76.25。E5(2022)解决的是适用范围问题:在弱监督文本对语料上做对比预训练,一次评测覆盖 MTEB 和 BEIR 共 56 个数据集(检索、聚类、分类),成为第一个零样本、不靠任何标注数据就在 BEIR 检索基准上超过 BM25 的向量模型族。
每篇到底改了什么
Sentence-BERT 改的是架构和成本账。原生 BERT 两句同读、输出一个分数,准但是平方复杂度:n 句两两比就是 n² 次前向。SBERT 把 BERT 改成孪生网络,每句单独编码成定长向量,相似度变成向量间点积。论文里最值得记住的不是准确率,是那张成本表:同样 1 万句的任务,cross-encoder 在 V100 上要约 65 小时,SBERT 约 5 秒编码加 0.01 秒余弦。今天语义搜索、去重、聚类、检索的整套基础设施,吃的就是这个「编码一次、随便比」的非对称红利。
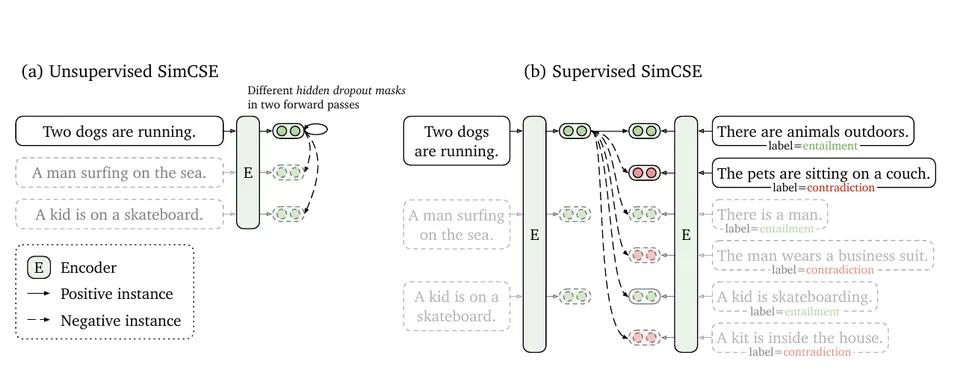
SimCSE 改的是正样本对的定义。对比学习需要同一内容的两个视角,此前靠裁词、删词、换近义词手工造。作者发现同一句子过同一个 encoder 两遍,本身就会得到两个不同向量,因为 dropout 每遍随机屏蔽的激活不同。用这个「dropout 对」当正样本,在 STS-B 开发集上打过所有手工增广。有监督版本沿用 NLI 数据集(蕴含句当正样本、矛盾句当负样本),这套配方两年前 SBERT 已经趟过路。
E5 改的是规模和评测口径。SBERT 和 SimCSE 优化的是 STS 这种短句对相似任务,E5 要做的是通用向量:检索、聚类、分类一个模型全包。它用很朴素的对比配方(batch 内负样本、大 batch)在海量弱监督文本对上预训练,然后在 56 个数据集上统一评测。两个核心主张:零样本(预训练完直接用)在 BEIR 检索基准上超过 BM25,此前没有任何向量模型在不靠任务标注微调的情况下做到;微调后在 MTEB 上拿到所比模型里的最好成绩,包括参数大 40 倍的模型。
关键数字
| 测量项 | Sentence-BERT | SimCSE | E5 | 设定与出处 | 同一套评测? |
|---|---|---|---|---|---|
| 1 万句中找最相似一对,耗时 | 约 5 秒(编码)+0.01 秒(余弦) | 不适用 | 不适用 | SBERT 论文第 1 节,V100 | 同段文字中 cross-encoder BERT:约 65 小时 / 约 5000 万次推理 |
| STS 平均 Spearman,BERT-base 家族,无监督 | 不适用 | 76.25 | 不适用 | SimCSE 论文 Table 1,7 个 STS 任务 | 是:同表 BERT-base 为 72.05 |
| STS 平均 Spearman,BERT-base 家族,有监督(NLI) | 79.39(SBERT-base 行) | 81.57 | 不适用 | SimCSE 论文 Table 2 | 是:SBERT 由 SimCSE 作者在同一张表里重新评测 |
| STS 平均 Spearman,非 STS 训练模型 | 77.03(SBERT-NLI-base)/ 79.23(SBERT-NLI-large);原生 BERT 向量 46.35 | 不适用 | 不适用 | SBERT 论文 Table 1 | SBERT 论文内部对比 |
| STS-B Spearman,直接在 STS-B 上微调 | 84.67(SBERT-STSb-base);BERT-STSb-base 84.30 | 82.5(开发集,dropout 对) | 不适用 | SBERT 论文 Table 1;SimCSE 论文 Table 1(开发集) | 设定不同,见下面一段提醒 |
| 有监督 SimCSE,RoBERTa-large | 不适用 | 83.76 | 不适用 | SimCSE 论文 Table 2 | SimCSE 内部尺寸扩展 |
| 零样本检索,BEIR | 不适用 | 不适用 | 超过 BM25(首个不靠标注做到这一点的模型族) | E5 论文,56 个 MTEB+BEIR 数据集 | E5 自建的评测套件;BM25 为词法基线 |
| 微调后检索/聚类/分类,MTEB | 不适用 | 不适用 | 所比模型中最优,超过参数 40 倍的模型 | E5 论文 | E5 自建套件 |
读这张表要按列读,因为三篇论文的任务口径本就不同。真正严格同口径的跨方法对比只有 SimCSE 那两张表:Table 1 里无监督 SimCSE-BERT-base 对的是他们自己评测的 BERT-base 基线,Table 2 里对的是他们自己重新评测的 SBERT-base。其余都是各论文各自口径下的数字摆在一起,这也是读网上任何向量模型对比时应有的态度。
SBERT 的真贡献是成本,它自己的表也承认
SBERT 论文里最没人引、却最有教益的一行是这个:当 BERT 和 SBERT 都在 STS-B 训练集上直接微调后,差距几乎消失,SBERT-STSb-base 84.67,BERT-STSb-base 84.30。给了同样的标注数据,cross-encoder 在双塔模型自家的基准上能追平。它做不到的是在 1 万句上 5 秒跑完,因为每比一对都要联跑一次前向。
所以 65 小时变 5 秒才是真贡献。语义搜索、去重、聚类、大规模检索,首先是推理形态问题,然后才是准确率问题。SBERT 让「向量接口」(编码一次、永久可比)成为这些任务的默认架构,后面两篇论文干的其实是同一件事:把这套接口吐出来的向量质量往上抬。
dropout 为什么能当增广用
SimCSE 在 STS-B 开发集上的消融表量出了手工增广有多脆:什么都不做、就用 dropout 对,82.5;删一个词,75.9;裁掉 10% 长度,77.8;用 MLM 预测替换词,直接崩到 62.2。原因不难懂:删词改词会改变句意,模型却被告知这些「改了意思的对子」算同义,几何结构就被带歪了。dropout 只扰动激活不动词,正样本对确实同义。
论文还把这件事和 BERT 向量的一个老毛病连起来:各向异性(anisotropy),预训练向量挤在向量空间的一个窄锥里,不相关句子的余弦相似度虚高。作者从理论和实验两侧说明,dropout 正样本对的对比目标能把分布摊开。这解释了无监督主数字:同一个 SimCSE 评测里 BERT-base 平均 72.05,SimCSE 拉到 76.25,论文概括为比此前最好的无监督结果高 4.2 个点;叠上 NLI 监督到 81.57,比此前最好有监督结果高 2.2 个点,落到本对比里更具体:比同一张表里的 SBERT-base 行高 2.18 个点。
E5 把目标从相似度挪到检索
E5 和前两篇的真正分野在评测口径。STS 任务是短句、干净、长度接近的成对打分;检索、聚类、分类问的是:一个向量能不能服务百万文档索引里的查询、按主题给文档分组、喂给线性分类头。E5 在 MTEB 和 BEIR 共 56 个数据集上报告,两个主张都是关于广度的:其一,零样本(预训练完直接用)在 BEIR 检索基准上超过 BM25,此前没有向量模型不靠任务标注微调做到过;其二,微调后在 MTEB 上拿到所比模型里的最好成绩,包括参数 40 倍的对手。
两个主张都要加「截至 2022 年」的限定,因为向量模型这个领域之后跑得飞快。但方法论层面的想法一直有效:海量精选弱监督文本对上加朴素的 batch 内负样本对比损失,中等尺寸的编码器就能在几十个任务上不换架构地打平打胜,这套配方到今天仍是多数开源向量模型的模板。
怎么选
- 手上已有 BERT 尺寸模型,做相似度或聚类,没有任何标注对: 无监督 SimCSE。在预训练编码器上加几行代码的事,76.25 的平均 Spearman 是很强的起点。
- 有 NLI 类标注对,或者能复用 SNLI、MultiNLI: 有监督 SimCSE,同评测下 BERT-base 拿到 81.57,压过同表 SBERT-base。
- 面向网页级文本做检索、聚类、分类,需要一个通用向量: 这是 E5 的场景。它的价值在 56 个数据集的评测广度和零样本超 BM25 这个结果,不在 STS 上赢谁。
- 在 cross-encoder 和向量模型之间给相似度产品做选型: 记住 SBERT 那张表。如果只要小标注集上的准确率、联式编码又算得起,cross-encoder 不输;如果要编码一次、比对百万次,向量是唯一可行的形态,剩下的问题是上面三条里哪条配得上你的数据。
局限与存疑
三篇论文都只在英文基准上评测,上面的数字不能自动迁移到其他语言,也不能自动迁移到法律、医疗、代码等领域。同口径行只存在于 SimCSE 的评测里,它也是三篇中唯一重跑过对手模型的一篇;SBERT 和 E5 的数字来自各自协议、各自底座,跨论文差距小于两三个点的部分应当当噪声读。这个领域也已经翻篇:指令微调和 API 向量模型如今占据着这些论文参与定义的榜单,比 dropout 对更精细的各向异性校正也早就有了。把这三篇当作三个坐标系来读就好:向量为什么快(SBERT)、对比目标怎么修好几何(SimCSE)、检索级评测为什么不能只看 STS(E5)。
常见问题
STS 上 Sentence-BERT 和 SimCSE 谁好?
按 SimCSE 作者自己跑的评测,SimCSE 好:有监督 SimCSE-BERT-base 在 7 个 STS 任务上平均 Spearman 81.57,同表 SBERT-base 行是 79.39;完全无标注的无监督 SimCSE 也有 76.25,同评测里 BERT-base 是 72.05。能重训就选 SimCSE;SBERT 是历史上绕不开的基线,SimCSE 论文自己都拿它当有监督参照。
原生 BERT 向量拿来做余弦相似度为什么不行?
因为各向异性:预训练 BERT 的向量挤在向量空间的一个窄锥里,不相关句子的余弦相似度虚高、区分度塌掉。SBERT 论文实测过,原生 BERT 向量在 STS 任务上平均 Spearman 只有 46.35,还不如简单的 GloVe 平均。SimCSE 则从理论和实验上说明,dropout 正样本对的对比目标能把分布摊开,这是它无监督增益的重要来源。
SimCSE 真的无监督吗?正样本对从哪来?
真的。正样本对就是同一句子过两遍同一个 encoder:dropout 每遍随机屏蔽不同的激活,两个向量略有差异但词完全相同的。STS-B 开发集上这个做法大幅领先显式增广:dropout 对 82.5,删一个词 75.9,裁 10% 长度 77.8,MLM 换词 62.2。
微调后的 BERT 能在 STS-B 上追平 SBERT,那 SBERT 的贡献是什么?
索引时间的成本。两者都在 STS-B 上微调后准确率几乎打平(84.67 对 84.30),但 cross-encoder 每比一对都要联跑一次前向,1 万句全对约 65 小时(V100);SBERT 每句只编码一次,总计约 5 秒,之后向量间余弦随便算。SBERT 的贡献是让向量接口变得实用,而不是赢基准。
什么时候该用 E5 而不是 SimCSE?
当你的任务是面向通用网页文本的检索、聚类或分类,而不是成对句子相似度,尤其当你要零样本行为时。E5 在 56 个 MTEB+BEIR 数据集上评测,是首个零样本、无标注就在 BEIR 上超过 BM25 的向量模型族,微调后又压过参数 40 倍的对手。如果是窄口径的 STS 式相似任务、预算只有 BERT 尺寸,SimCSE 的数字是更直接的证据。