
Whisper 对比 Mega-ASR:让语音识别扛住真实世界的两种路线
Whisper 赌 68 万小时真实网络音频的多样性;Mega-ASR 造 240 万条合成退化片段,VOiCES 上 WER 45.69% 对 54.01%。两边数字不在同一张考卷上。
岔路口:把世界放大,还是把最差的房间造出来
语音识别在干净的朗读音频上接近解决,在一条从嘈杂大街上打来的电话里仍然很差。本站上的两篇论文从相反方向打这个缺口,而它们的分歧正是值得理解的东西。
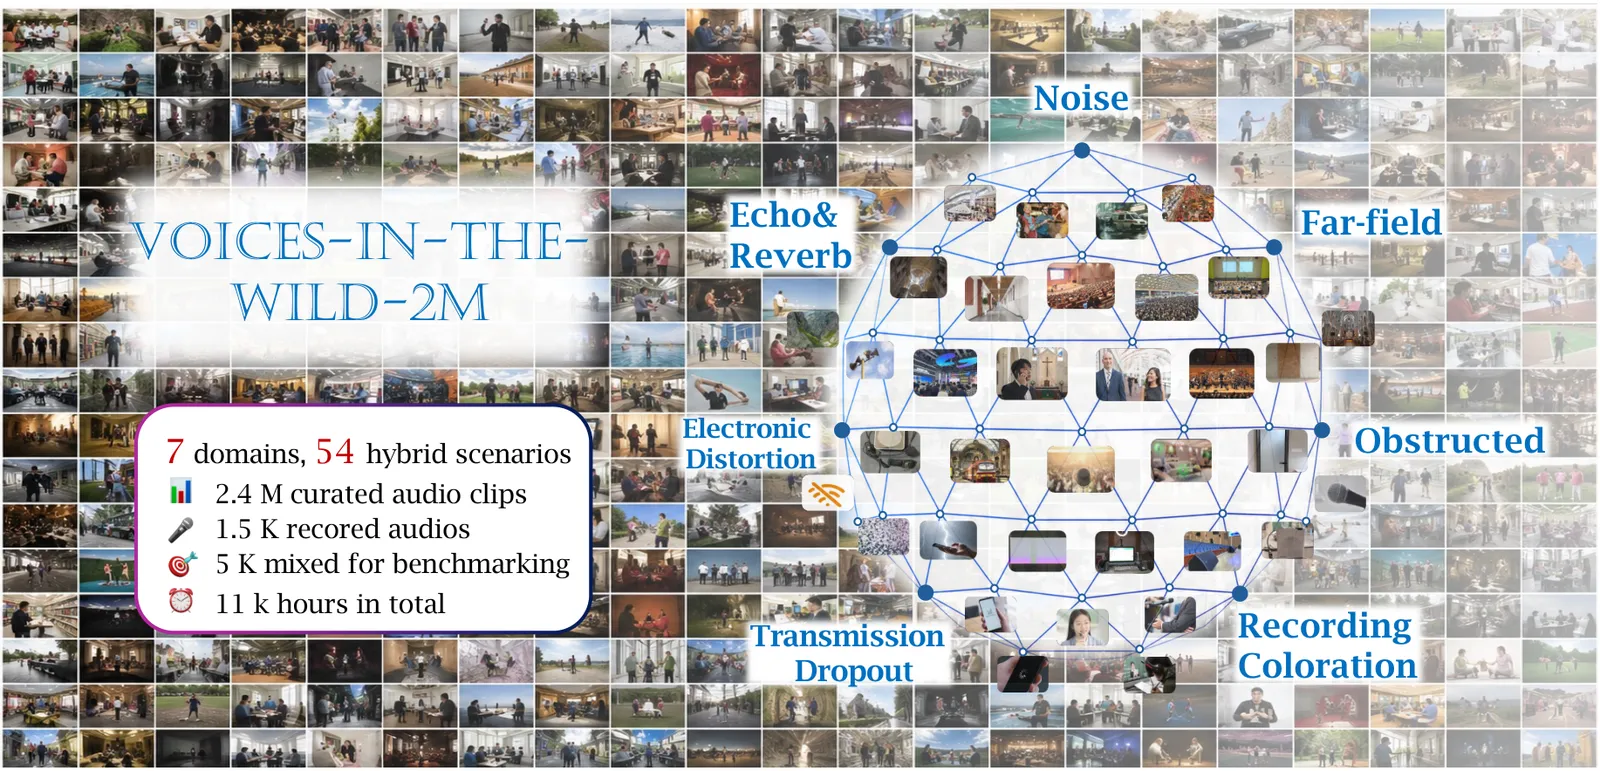
OpenAI 的 Whisper 赌的是真实数据的规模:一个普通的 Transformer 编码器解码器,直接拿 68 万小时的网络音频配上「网上本来就有的字幕」来训,赌数据的多样性本身能让模型在任何场景下平缓退化。Mega-ASR 赌的是可控的难度:既然没人有一大语料的「复合退化」语音,那就造一个,做出 240 万条片段、覆盖 7 种基础声学现象、组合成 54 种物理上说得通的复合场景,然后拿它去微调一个现成的 17 亿参数模型。
两篇论文都把结果叫鲁棒,但指的是不同的失效模式、报的是不同的数字、从不出现在对方的基准上。先看表,再看这张表不能告诉你什么。
关键数字
| 维度 | Whisper | Mega-ASR | 同口径? |
|---|---|---|---|
| 核心赌注 | 68 万小时弱监督网络音频 | 240 万条合成退化片段(约 1.1 万小时) | 否 |
| 数据性质 | 真实、杂乱、多语种;约 12.5 万小时是翻译数据 | 合成但物理有据;7 种基础现象(噪声、远场、遮挡、回声混响、录音染色、电子失真、传输丢包)组合成 54 种复合场景;英语和普通话 | 否 |
| 底座架构 | 普通 Transformer 编码器解码器,log-Mel 输入 | 微调 Qwen3-ASR-1.7B,增益来自数据和训练,不是更大的骨干 | 否 |
| 头部数字 | 零样本即在标准基准上接近全监督系统;在 OpenAI 的对比中逼近人类准确率;无单一冠军 WER | VOiCES R4-B-F:WER 45.69% 对前 SOTA 54.01%;NOIZEUS Sta-0:21.49% 对 29.34%;最难复合条件相对 WER 降幅超 30% | 无共享基准 |
| 训练配方 | 一次大规模监督训练,数据经启发式过滤 | 两阶段:A2S-SFT(按 WER 阈值排序难度的课程学习)加 DG-WGPO(按 WER 门控的 RL,句级加词级双粒度奖励) | 否 |
| 评测重心 | 分布偏移下仍然站得住的准确率,对微调专用模型的优势 | 恶劣条件:远场、混响、编解码损耗、叠加退化;基准刻意混入 3500 合成与 1500 真实片段 | 否 |
| 放出了什么 | 模型和推理代码 | 数据集构建流程与训练配方;基准共 5000 条 | 不适用 |
这张表上没有的东西比有的更重要:**没有任何一个数字把 Whisper 和 Mega-ASR 放进同一段音频里比过。**Whisper 的证据是「零样本、有竞争力、跨偏移稳定」,说的是误差随条件变化的斜率,不是一个分数;Mega-ASR 的证据是具体的 WER 降幅,但只在为退化音频设计的基准上。任何给你「单一赢家加领先幅度」的对照页都是在编一个两篇论文都没做过的测量。
Whisper 到底买到了什么
68 万小时这个数字就是论文本身。学术 ASR 通常用约 1000 小时干净标注语音训练,Whisper 多了三个数量级,并且接受了随之而来的噪声:自动生成的字幕、对齐错误的音文对、参差不齐的质量。OpenAI 过滤掉机器生成的转写,因为拿另一个 ASR 系统的输出当标签等于学它的错误,再用启发式规则丢掉对不齐的样本,但监督信号按设计就是弱的。赌注在于:一个见过互联网上各种口音、编解码器、录音环境的模型,不需要为你的场景微调,因为你的场景已经在数据里了。
让它成为基础设施的工程窍门简单到近乎朴素:转写、X→英语翻译、语种识别、时间戳预测,全部只是解码序列开头的几个文本 token,一个 checkpoint 家族覆盖四件事。加上放出的模型和推理代码,这就是 Whisper 从论文变成默认件的原因。
同样明确的还有它的诚实短板。Whisper 在静音和非语音音频上会幻觉出流利的文本,这在医疗、法律、无障碍场景里很要命,因为一份自信的错稿比没有稿更糟。语种覆盖严重偏向高资源语言。而 68 万小时的语料本身从未放出,结果无法完整复现。
Mega-ASR 到底买到了什么
Mega-ASR 的诊断是:这个领域剩下的失效不是一般的偏移,是叠加退化:远场采集加混响加编解码损耗加丢包同时发生,这才是一通真实电话的样子。没有训练语料系统覆盖这种情况,所以作者造了 Voices-in-the-Wild-2M:240 万条、约 1.1 万小时,7 种基础声学现象组合成 54 种物理上合理的复合,而非随机混合。配套的基准刻意留出 1500 条真实录音对着 3500 条合成,模型没法靠过拟合模拟器取胜。
训练故事是贡献的另一半。Mega-ASR 不去放大骨干,而是两阶段微调 Qwen3-ASR-1.7B:A2S-SFT 用 WER 阈值按难度排序样本,让模型从声学解码过渡到语义恢复;DG-WGPO 再加一个强化阶段,奖励被真实 WER 在句级和词级两个粒度上门控,策略只有在转写准确率真的上升时才得分。站内页面说得很直白:增益来自数据和训练,不来自更大的模型。
实测结果是本次对比里最具体的:VOiCES R4-B-F 上 WER 45.69% 对前 SOTA 54.01%,NOIZEUS Sta-0 上 21.49% 对 29.34%,最难复合条件相对降幅超 30%。诚实的限制同样清楚:训练语料大部分是合成的;54 种场景是设计出来的分类法,不是真实世界的真实长尾;VOiCES 上的强项对干净的 LibriSpeech 式音频无话可说,那里本来就没什么可提升的空间。
你算不出来的那个数字
读者想要「Whisper vs Mega-ASR」页面给出一样东西:一个赢家。诚实的回答是这个问题有两处先天 malformed。
第一,两个指标活在不同区间。Whisper 的核心主张是它在分布偏移下损失的准确率更少,这是退化斜率的声明,不是点分。Mega-ASR 的主张是点分,但只在退化类基准上。一个模型可以满足 Whisper 的标准(各条件下误差平稳),在 VOiCES 上的绝对 WER 仍高于退化专用模型;反过来也一样。
第二,两篇论文对「真实世界」是什么有不同定义。Whisper 把真实世界当作已经在训练数据里:抓的互联网足够多,野外就变成分布内。Mega-ASR 把真实世界当作任何语料在结构上都不存在:房间、设备、叠加效果的尾巴是无穷的,唯一可控的杠杆是一台会把最难情况组合出来的模拟器。两边都有证据,也都有洞:Whisper 的语料没放出、缺了某个领域也没法补;Mega-ASR 的模拟器是世界的模型,而那 1500 条真实样本之所以存在,正是因为作者知道这一点。
所以实际决策不是「谁更好」,而是「你的音频在哪个区间」。如果音频像互联网(播客、电话、视频、多语种、条件未知),Whisper 的多样性赌注是对的,而且今天就能用。如果音频是可预期的恶劣(远场麦克风、混响房间、有损传输),Mega-ASR 证明了精心设计的模拟语料加一条讲究的课程,能买到「堆规模碰运气」买不到的实测 WER 降幅。
第三条路:别等音频结束
两篇论文都假设一个离线交易:音频结束,然后转写。站内的 Audio Interaction Model 论文瞄准的是上一层:一个流式音频大模型,跑「感知、决策、回应」循环,边听边转,更重要的是学会什么时候该回应,而不是等一个静音计时器。它的语料 StreamAudio-2M 约 260 万条,覆盖 7 项核心能力与 28 个子任务;模型在 8 个基准上报告为「有竞争力」,作者另造了 Proactive-Sound-Bench 来测轮流式基准从不测试的主动介入决策。
这里的数字刻意更软:「8 个基准有竞争力」,没有公布单基准分数或延迟数据,站内页面也如实说了。它在这场对比里的位置是方向性的:退化音频上的识别准确率和交互时机是两个独立问题,把前者打满的系统在后者上仍然可能难用。如果你的产品是实时助手而不是转写机,这条线才该追,附带一句保留:论文发布时权重、数据和外部验证都还没有。
怎么选
- **今天要即插即用的多语种转写、条件未知、语种混杂:**Whisper。模型和代码已放出,一个 checkpoint 四项任务,68 万小时真实音频撑起来的稳定性。高风险场景要为幻觉检查留预算。
- **音频是可预期的恶劣场景(远场、混响、有损、叠加退化)且你能掌控训练:**Mega-ASR 的配方。VOiCES 和 NOIZEUS 上的数字是本站对恰恰这个区间最强的实测证据,而且「在 17 亿底座上微调」意味着你不需要前沿算力就能复用这套打法。
- **挑基准时要警惕任何单一 WER:**Whisper 的强项是跨偏移误差平稳,Mega-ASR 的强项是设计出来的难题上误差低。让基准匹配你的部署场景,否则你会选错专科医生。
- **实时交互(延迟、轮流、对环境声反应):**Whisper 和 Mega-ASR 都不是对的工具,那是流式音频大模型的问题,而且那还很早期。
局限与存疑
和本站大多数方法对比一样,缺的实验是控制变量那一个:Whisper 规模的真实数据和 Mega-ASR 规模的模拟数据,走同一条训练配方,在同一个真实加退化混合基准上评测。在那之前,「数据规模胜过模拟」和它的反命题都只是从设计哲学加部分测量外推。Whisper 在非语音输入下的幻觉行为仍是个悬而未决的可靠性问题,未放出的语料让独立验证无从谈起。Mega-ASR 用 1500 条真实片段论证合成到真实的迁移,诚实但单薄。而三篇论文都早于下一个编解码器、下一款设备、下一种声学环境对「野外」定义的改写,鲁棒性声明的老化速度比基准表显示的快。
常见问题
Mega-ASR 比 Whisper 强吗?
两者从未被放在一起测过,所以不存在诚实的「是」或「否」。Mega-ASR 在退化音频基准上给出了具体 WER(VOiCES R4-B-F 45.69% 对 54.01%,NOIZEUS Sta-0 21.49% 对 29.34%);Whisper 的主张是跨条件的零样本稳定,没有单一冠军分数。音频是远场或有损时,Mega-ASR 的数字是相关证据;音频是通用多语种时,Whisper 的是。
Whisper 是用什么训练的?
68 万小时网络标注音频,字幕是网上现成的、质量参差,这就是「弱监督」的意思。其中约 12.5 万小时是翻译对,这也是同一模型既能转写又能翻译的原因。语料本身没有放出。
Mega-ASR 把词错误率降低了多少?
VOiCES R4-B-F 上报告 45.69% WER,前 SOTA 为 54.01%;NOIZEUS Sta-0 上 21.49% 对 29.34%。在最难的复合退化条件上相对 WER 降幅超 30%。实现方式是在 240 万条合成语料上微调 Qwen3-ASR-1.7B。
为什么不把 Whisper 直接放到 Mega-ASR 的合成数据上训?
两篇论文都没有禁止这一点,这显然是最自然的下一个实验。但它没做过:Whisper 赌真实世界的多样性足以覆盖退化的尾巴,Mega-ASR 赌设计好的复合场景比互联网覆盖得更好。把 68 万小时真实数据和 54 种设计场景结合起来是一个研究课题,不是任何一篇论文已经得出的结论。
流式音频模型处在什么位置?
Audio Interaction Model 处理的是另一层问题:成品片段上的准确率之外,还有实时感知、决定何时开口、对环境声主动反应。它在 260 万条的 StreamAudio-2M 语料上报告 8 个基准「有竞争力」,但截至论文发布,没有放出的权重和单基准分数。
一句话:Whisper 把真实音频堆到野外变成分布内;Mega-ASR 把野外最差的会议室造出来,直到 17 亿参数的模型能活下来;两个数字互不可比,而这正是这次对比的结论。