
智能体记忆架构对比:外部换页、图重建、参数化旁路与更新补丁
MemGPT 像操作系统一样换页,MRAgent 边推理边重建记忆图,δ-mem 把历史压进 8×8 参数状态,EvoMem 记录事实如何被改写:四种架构,四个「记忆放在哪」的答案。
同一个问题,四个答案
所有智能体记忆系统都在回答同一个问题:过去存放在哪里,由谁决定把什么加载进上下文? 本页对比的四个系统给出了四个真正不同的答案,而且差异比基准分数更重要,因为它们直接决定了成本结构、可审计性,以及各自「会怎么忘」。
MemGPT 认为记忆在模型之外,放在分层的外部存储里,由大模型自己通过函数调用把数据换入换出,等于给智能体做了一个微型操作系统。MRAgent 同样把记忆放在模型外,但组织成 Cue-Tag-Content 图,智能体在推理过程中边走边剪枝,而不是一次性取回固定的 top-k。δ-mem 认为记忆应该长在模型里:一个 8×8 的联想状态,用 delta 规则更新,读取时以低秩修正注入注意力,完全没有检索这一步。而 EvoMem 在 EvoArena 基准上指出,症结不在记忆放哪,而在记了什么:智能体需要的是记录「事实如何被改写」的更新补丁,而不是只存最新快照。
关键数字
| 系统 | 记忆存放在哪 | 代表性结果 | 基准与设定 | 同一套测试条件? |
|---|---|---|---|---|
| MemGPT(GPT-4 后端) | 外部:recall + archival 存储,由 LLM 换页 | 93.4%,递归摘要基线 35.3% | 深记忆检索(DMR),500 段多会话对话 | 是,同后端同基准 |
| MRAgent(Gemini-2.5-Flash 后端) | 外部:Cue-Tag-Content 图,主动遍历 | 84.21,Mem0 为 68.31(相对 +23.3%) | LoCoMo,LLM-Judge,共享冻结后端 | 是,架子对架子 |
| MRAgent 成本 | — | 每样本 118k token、586 秒;A-Mem 632k token,LangMem 3268k | LongMemEval | 是,统一按样本计 token |
| δ-mem(冻结全注意力 LLM) | 内部:固定 8×8 在线状态,delta 规则更新 | 平均较基座 1.10×,较最强记忆方法 1.15× | 长记忆任务平均 | 是,同基座家族 |
| δ-mem 分基准 | — | MemoryAgentBench 1.31×,LoCoMo 1.20× | 以相对倍数报告 | 同条件,但是比率不是绝对分 |
| EvoArena 基座智能体 | 最新状态记忆 | 平均 39.6%;链级准确率 21.5% / 10.6% / 39.1% | Terminal-Bench-Evo / SWE-Chain-Evo / PersonaMem-Evo | 是,三域同一批评测 |
| EvoMem | 记录「改了什么、为什么、证据是什么」的补丁 | 平均 +1.5,步级 +2.6,链级 +3.7;GAIA +6.1,LoCoMo +4.8 | EvoArena 加标准基准 | 是,同智能体对比补丁记忆与最新状态记忆 |
这张表更该读的是没有什么:没有任何两行共享同一个基准。MemGPT 的 93.4% 和 MRAgent 的 84.21 是两种任务,和 δ-mem 的 1.15× 倍数、EvoMem 的 +3.7 个点更不能直接比大小。跨系统能下的结论是设计层面的:成本结构、失效模式、各自保留了什么,而不是给这些分数排名。
换页:MemGPT 与操作系统类比
MemGPT 的核心动作是不再把上下文窗口当记忆,而是把它当内存(RAM)。系统给模型一段固定的系统指令、一块可写的工作记忆,以及追加、检索、驱逐三类工具;当 FIFO 消息队列逼近 token 上限时,模型会在溢出之前收到警告,自己决定哪些内容刷进 recall 存储、哪些压缩成摘要。在深记忆检索基准上(500 段对话、每段 5 个会话,问题只能依靠回忆更早的会话作答),这种自管理换页在 GPT-4 上拿到 93.4%,而递归摘要只有 35.3%。这个差距就是摘要的代价:你需要的事实早在三个会话之前就被平均掉了。
这个设计的弱点和它的优点对称:每次记忆操作都是一次 LLM 决策,所以一个忘了保存、或检索很烂的后端会静默丢信息;系统把「保留」这件事委托给了模型,而不是保证它。而且一轮用户对话可能触发多次搜索和写入,每次都是一次付费调用,延迟和成本都随智能体管理记忆的积极程度上升。
图记忆:MRAgent 与主动重建
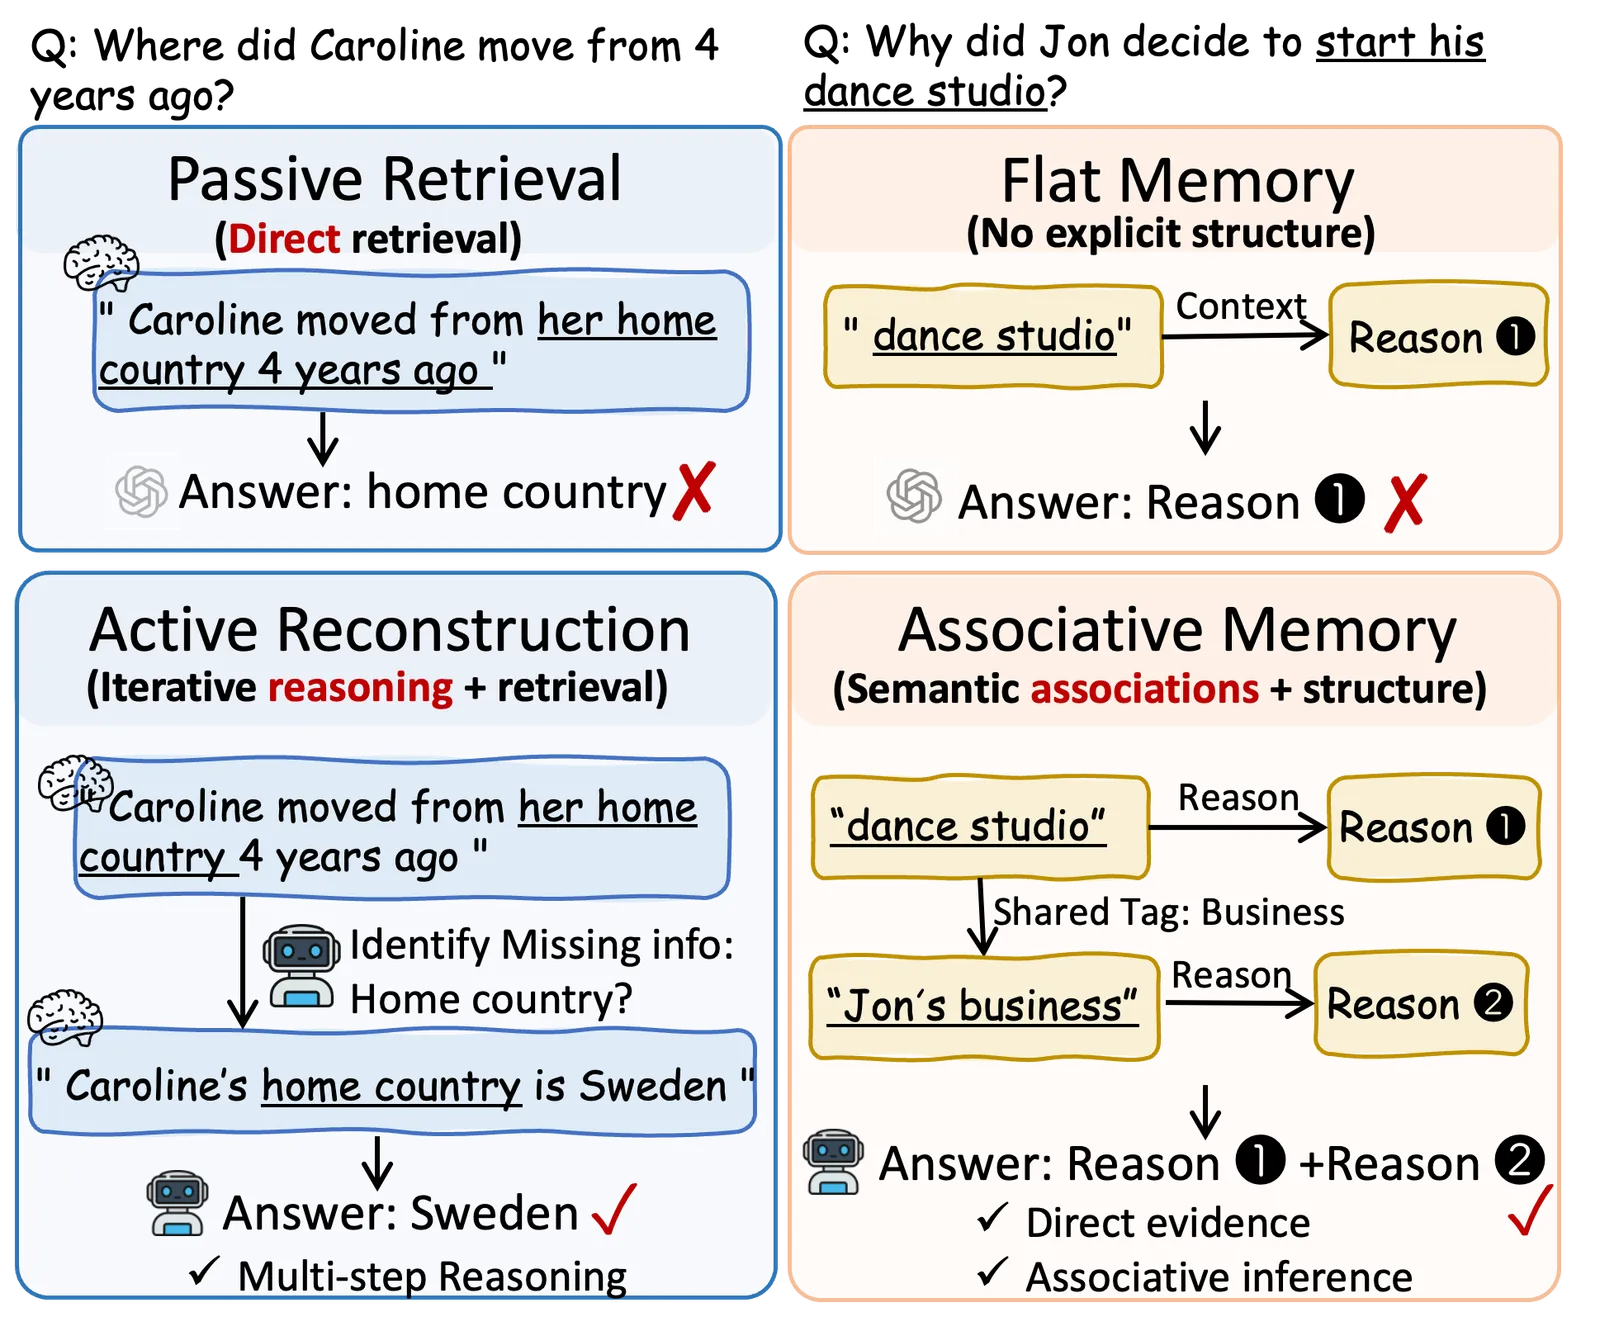
MRAgent 也把记忆放在外部,但改的是检索契约。它不按固定 top-k 取回后只推理一次,而是把遍历和推理交织起来:每一轮从 Cue-Tag-Content 图中选标签、展开对应分支、剪掉无关部分,直到检查器判定证据足以回答问题。论文用定理证明了这一点:检索预算至少为 2 时,被动的「先取后想」假设类严格被主动类包含。基准上更直观:LoCoMo 上时间类问题从 Mem0 的 61.68 跳到 80.37,因为回答「锦标赛是几月办的」需要先从中途证据里推断出「七月」这个时间锚点,一次性取回的检索器做不到。
表里最有意思的是成本行。MRAgent 每轮查询比基线做了更多推理,最终却是被测系统里最省钱的:LongMemEval 上每样本 118k token,对比 A-Mem 的 632k 和 LangMem 的 3268k。诀窍是把重活推迟:构图保持轻量,关系推理只在查询时、只围绕一个问题发生,标签先把昂贵的情景文本过滤掉再加载。代价是:两个后端都是闭源前沿模型,整套增益建立在「模型足够可靠、能在搜索中途推断出正确线索」之上。
旁路状态:δ-mem 与无检索记忆
δ-mem 押的是相反的注:干脆不要存储。它在一个冻结的全注意力 LLM 上外挂一个固定 8×8 的联想记忆矩阵。新 token 到达时用 delta 规则更新状态,写入的是「状态预测」与「实际发生」之间的误差,旧关联被覆盖而不是无限堆积;读取时以低秩修正注入骨干的注意力。因为状态永远不增长,无论对话多长,每步成本都持平,既没有检索延迟,也不重复占用上下文。
以倍数报告的收益是:平均较冻结基座 1.10×、较最强竞争记忆方法 1.15×,其中 MemoryAgentBench 上 1.31×、LoCoMo 上 1.20×。读这些数字要小心:它们是相对比率,绝对分数和基线身份都要回论文里看;而且较无记忆模型 1.10× 的平均提升是真实但有限的。天花板问题是内在的:8×8 的状态是个非常小的容器,装一段很长的历史,论文没有展示它从何处开始丢掉 delta 规则保不住的事实。这条路还要求你掌控模型栈,没法挂在一个托管 API 模型上。
补丁:EvoMem 与「变化」的记忆
EvoArena 把问题从容量换到了时效。它的三个域(终端任务、软件仓库、用户偏好)被打包成带版本的演化链,结果相当清醒:基座智能体在演化域上平均只有 39.6%,链级准确率比步级坍缩得更厉害(Terminal-Bench-Evo 21.5%、SWE-Chain-Evo 10.6%),因为一个智能体解得开某个快照,当 CLI、依赖或偏好在它脚下变掉时照样失败。最新状态记忆正是元凶:一次更新覆盖旧规则时,「这次变化本身」的记录就没了,依赖这段变迁的后续任务随之无解。
EvoMem 的修法小而对症:把非增量更新记成结构化补丁(改了什么、为什么改、新旧状态差在哪、什么证据触发的),检索时把补丁和当前记忆一起取回。增益是温和的(EvoArena 平均 +1.5,其中步级 +2.6、链级 +3.7,GAIA +6.1、LoCoMo +4.8),但方向才是重点:保留更新历史是比存最新快照更好的原语,而链级数字说明,无论哪种,智能体都远谈不上可靠。
怎么选
- 需要无界、可审计的记忆,且模型是托管 API: MemGPT 式换页。它不要求改造模型,每次记忆写入都是一次显式、可检查的动作。
- 查询是多跳或时间型,一次性 top-k 总 miss: MRAgent 式、带主动重建的图记忆。给推理循环配一个更强的后端,因为它生死系于模型在中途的推断质量。
- 自己掌握模型权重,想要零检索延迟: δ-mem 式参数化旁路。代价是你无法审计那个 8×8 状态到底记住了什么。
- 环境本身在变(API、代码库、用户偏好): 在现有任意存储上加补丁记忆。EvoMem 的增益不大,但它修的失效是结构性的,而且是四者中最容易落地的。
局限与存疑
没有任何受控研究把四套系统放进同一个基准、配上相同后端,所以设计层面的结论站得住,排名层面的结论站不住。对话记忆的结果(DMR、LoCoMo、LongMemEval)来自会话场景;同样的排序对工具调用日志、代码历史或多模态数据是否成立,尚未验证。δ-mem 的比率掩盖了绝对分数,MRAgent 在 LongMemEval 上最好的 86.76 用的是混合后端设定,EvoMem 的增益虽然方向一致,但 EvoArena 三个域里有两个链级准确率仍低于 15%。横切四个系统的开放问题是:它们都假设模型是不可靠的那一环、靠记忆基础设施来救;而 EvoArena 的 39.6% 提示瓶颈可能是「对变化进行推理」,而不是存储。
常见问题
大模型智能体记忆主要有哪几种架构?
近年的文献里四种架构最有代表性:由大模型自己换页的外部存储(MemGPT)、推理过程中遍历的外部图(MRAgent)、模型内部由 delta 规则更新的小型参数化状态(δ-mem),以及记录事实如何变化的补丁历史(EvoMem)。它们的区别在于记忆存放在哪、由谁控制加载、各自会怎么遗忘。
检索方法与长上下文窗口,哪个更好?
就本页的证据看,长程回忆上是的。MemGPT 在深记忆检索上拿到 93.4%,递归摘要只有 35.3%;δ-mem 的前提同样是窗口再大也救不了利用率(「迷失在中间」是用的问题,不是容量的问题)。但两者都要求模型对已加载的内容推理正确。
哪种智能体记忆系统最便宜?
要看计哪个维度的成本。MRAgent 报告的 token 账单最低(LongMemEval 每样本 118k token,对比 A-Mem 632k、LangMem 3268k),尽管它每轮推理更多。δ-mem 完全没有检索成本,但要改模型。MemGPT 的成本随每轮触发多少次记忆函数调用而浮动。
为什么最新状态的记忆方法会忘掉被更新过的事实?
因为大多数记忆存储只保留最新状态。EvoArena 显示智能体在演化环境上平均只有 39.6%,SWE-Chain-Evo 链级低至 10.6%;EvoMem 的补丁记忆保留了「改了什么、为什么改」,换回链级 +3.7,是真的,但只修好了部分。
这些架构能组合吗?
能,而且论文们就是这么邀请你的。EvoMem 明确定位为现有记忆系统之上的插件而非替代品,MemGPT 的分层也不在乎 archival 存储底层用的是什么索引。真正互斥的只有 δ-mem:它需要触达骨干的注意力计算。
一句话:先决定记忆放在哪里,再谈基准:换页、图、旁路、补丁优化的是不同的失效模式。四篇的完整拆解见 MemGPT、MRAgent、δ-mem 与 EvoArena 解读页。