
AlphaCode 和 Code Llama 的区别:竞赛搜索对开放代码模型
AlphaCode 用海量采样加筛选换来 Codeforces 前 54.3%;Code Llama 把开放权重做到 HumanEval 67%:两台机器干的是两件事。
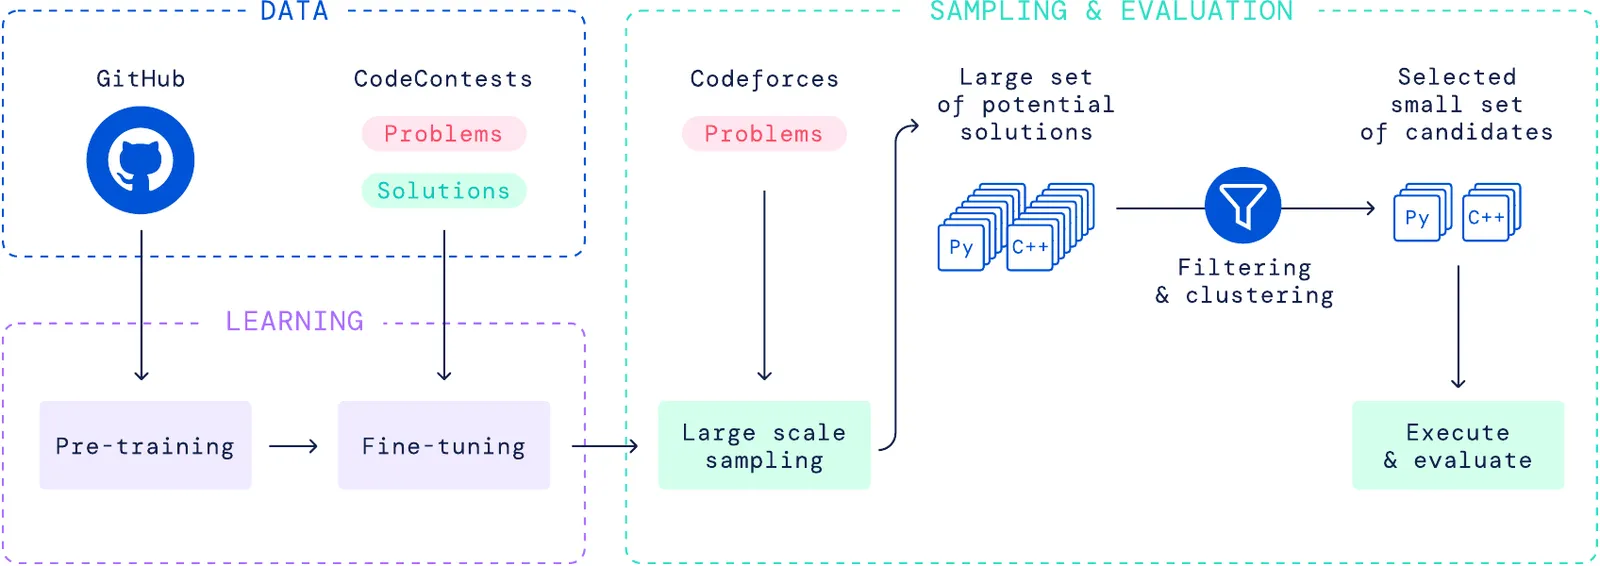
同一个标题,两台不同的机器
两篇论文讲的都是「AI 写程序」,也都拿出了真东西。DeepMind 2022 年的 AlphaCode 首次在模拟真实编程竞赛中拿到大致中位数的成绩:平均排名进入 5000 多人参赛全场的前 54.3%。Meta 2023 年 8 月的 Code Llama 是当时最强的开放代码模型家族,最高拿到 HumanEval 67%、MBPP 65%,许可证允许商用。
但它们回答的是两个问题。AlphaCode 问的是:单次猜测经常出错的模型,配上暴力采样和严格的挑选,在「只有 10 次提交机会」的比赛规则里能换回多少正确率?Code Llama 问的是:把一个已经很强的开放基座继续喂代码数据,单次生成究竟能好到什么程度,把权重免费开放,生态又会因此长出什么?
一个是围绕模型搭的推理时系统,一个是为部署而生的模型。把这两类混为一谈,几乎就是关于它俩最常见的误读,而 54.3% 和 67% 之所以没法并排比,根子也正在这里。
AlphaCode 的流水线
AlphaCode 论文自己的定位是:竞赛编程和当时的主流基准是两种运动。HumanEval 那类任务给你一段自包含的小函数描述;Codeforces 的题目却是一大段故事,你要先把故事翻译成形式化题面,再想出复杂度达标的算法、写对实现、顶住含对抗用例的隐藏测试。解法对 95% 也是零分,没有部分分,这恰好是语言模型「像样但不对」的死穴。
所以它用流水线而不是更大的模型来解题。竞赛数据直接抓很脏(样例过、隐藏测试挂),团队用额外生成的测试用例清洗了数据集。架构上刻意选了大编码器、小解码器的不对称 encoder-decoder 加多查询注意力,目的只有一个:把每个问题的采样量放大几个数量级,成本还撑得住。
推理时的数字就很夸张了:每个问题最多生成一百万个候选程序,约 99% 挂在题面自带的样例测试上被扔掉,幸存者按它们在模型自造输入上的行为聚类,每个簇交一个代表,凑够比赛允许的 10 次提交。前 54.3% 是整条流水线的产出(模型、过滤器、聚类),而不是模型单次生成的水平。说白了,单次采样解出难题的概率非常低;这篇论文证明的是「弱的单次成功率 × 海量采样 × 有纪律的筛选」能兑换成真实的比赛名次。这是一份穿着生成模型外衣的搜索成果。
Code Llama 的做法
Code Llama 从相反的角落出发。它不从零训练代码模型,而是拿 Llama 2 继续在代码数据上训练,再加任务特化阶段,让代码模型白得基座的语言推理能力。整个家族按 7B、13B、34B、70B 四个尺寸各出三条线:基础版管通用生成,Python 特化版面向 Python 技术栈,Instruct 版面向指令跟随的助手场景。
两个工程决策瞄准的是真实开发者,而不是榜单。一是填空(infilling):7B、13B、70B 的基础版和 Instruct 版能同时利用缺口前后的代码补全中间缺失的片段,这才是 IDE 补全真正需要的能力,因为人写代码从来不是严格从左往右。二是上下文:所有模型按 16k token 序列训练,在最长 100k token 的输入上都有增益,也就是说你能把仓库里一整块真实代码喂进去,而不是只给孤立的一个函数。
headline 的 67% HumanEval、65% MBPP 来自最大、最特化的配置。论文里更锋利的一个数据点是尺寸对特化的对比例子:Code Llama - Python 7B 在两项基准上都赢了自己的基座,通用的 Llama 2 70B。十分之一参数量、纯靠代码特化反超通用大模型;而且所有变体在 MultiPL-E 多语言基准上都是当时公开模型里最好的。再加上允许商用的许可证,这才是它改变生态的地方:这是大家真正能拿去构建的模型。
关键数字
| 指标 | AlphaCode | Code Llama | 设置与出处 | 同口径? |
|---|---|---|---|---|
| Codeforces 比赛成绩 | 平均排名前 54.3%,参赛 5000+ | 未评测 | AlphaCode,模拟近期比赛,限 10 次提交 | 本组资料没有 Code Llama 的数字 |
| HumanEval | 我们的来源未报告 | 最高 67% | Code Llama,最大配置,发布时开放模型最佳 | 本组资料没有 AlphaCode 的数字 |
| MBPP | 我们的来源未报告 | 最高 65% | Code Llama,同一发布 | 同上 |
| 每个任务的采样量 | 最多 100 万候选,约 99% 被样例测试刷掉,聚类到 10 次提交 | 每次调用 1 个补全 | AlphaCode 流水线 vs Code Llama 部署形态 | 不适用 |
| 尺寸梯队 | 不对称 encoder-decoder(大编码器、小解码器),多查询注意力压低采样成本 | 7B / 13B / 34B / 70B | 各自论文 | 不适用 |
| 特化对尺寸的证明 | 未报告 | Python 7B 在 HumanEval、MBPP 双超 Llama 2 70B | Code Llama 论文 | 不适用 |
| 上下文 | 对单题场景不是瓶颈 | 16k token 训练,最长 100k token 上有增益 | Code Llama 论文 | 不适用 |
| 多语言 | 未报告 | 所有变体在 MultiPL-E 上均为公开最佳 | Code Llama 论文 | 不适用 |
这张表刻意不给你的东西,请仔细读:没有任何一行是两边在同一任务、同一条件下测的。AlphaCode 报的是比赛名次,Code Llama 报的是短函数基准的通过率,两篇论文都没碰对方的评测。所以「AlphaCode X% 对 Code Llama Y%,所以谁更强」这类说法,本质是把提交次数受限下的名次百分比,和另一个任务族上的单次通过率硬凑在一起。
为什么 headline 数字不能直接比
54.3% 和 67% 之间隔着三层错位。
任务不同。 Codeforces 要求读故事、形式化、选算法、过对抗隐藏测试,对 95% 也是零分;HumanEval、MBPP 是自包含小函数,题面基本就是在描述实现。前者考的是评判下的算法创造,后者考的是局部实现熟练度。
指标语义不同。 前 54.3% 的意思是:整条系统带着 10 次提交的额度,在 5000 多人的参赛场里平均领先约 46% 的人。67% 的意思是:单次生成能通过约三分之二题目的单元测试。一个是靠提交预算买来的锦标赛名次,一个是每次尝试的成功率,连分母都不一样。
采样预算不同。 AlphaCode 的成绩明确建立在「最多百万候选 → 约 99% 被样例测试刷掉 → 聚类成 10 次提交」之上;Code Llama 的 67% 是单次前向。把两边拉到相同采样量,两个 headline 都活不下来:单次出手的 AlphaCode 在难题上几乎没用,而 Code Llama 的单次成功率从来没在百万采样搜索下测过。两篇论文根本不在同一个实验设计里。
怎么选
比赛场景是 AlphaCode 哲学的立足点。如果你的问题有自动评测、有隐藏测试、允许反复尝试(竞赛编程、某些「合成、验证」式研究回路),那么广采样加行为筛选,已被证明能把一个 modest 的模型推回看似不可能的成绩。这条路线的当代后裔,是规模化「生成、执行、筛选」的智能体编程范式,本站的 code as an agent harness 就是这一脉的延续。
其他一切场景都指向 Code Llama 的答案。IDE 补全、往文件中间填空、100k token 的仓库级上下文、私有化部署、针对内部代码库微调、在开放权重之上做商用产品:这些需要的是「每次调用一次好补全」,而不是一百万次。再算上宽松的许可证和四档尺寸,Code Llama 成为基础设施、AlphaCode 停留在研究里程碑,几乎没什么悬念。还要说明:两篇论文都早于智能体时代,也都没声称能做跨文件仓库级开发,那个前沿是另一批系统在打。
局限与存疑
这对组合里没有共享基准,按本站的来源纪律,这一页不会替你编一个。两篇论文的评测方式也都各挑对自己有利的战场:AlphaCode 用比赛模拟,Code Llama 用已近饱和的短函数基准,而 Code Llama 那页自己也承认,HumanEval 和 MBPP 说明不了「调试真实仓库」「维护大代码库」的能力。67%/65% 属于最大配置,笔记本跑得动的 7B 会明显更低。AlphaCode 的流水线则是研究产物:每个问题上百万采样的算力账单不是产品策略,而是关于「正确性可以从哪来」的科学陈述。两篇论文留下的是同一个开放问题:搜索到底什么时候不再是「装聪明」的昂贵方式,而一个够强的单次模型又会在什么时候让它彻底过时?
常见问题
AlphaCode 和 Code Llama 哪个更强?
两者没有直接可比性,因为生来干的是不同的活。AlphaCode 是推理时系统:每个问题最多采样一百万个候选,筛选加聚类后只用 10 次提交,换到模拟 Codeforces 全场前 54.3%。Code Llama 是开放模型家族,单次前向最高拿 HumanEval 67%、MBPP 65%。一个是围着模型搭的搜索流水线,一个是可以部署的权重。
为什么 AlphaCode 报比赛名次,Code Llama 报 HumanEval 百分比?
因为它们回答的问题不同。Codeforces 名次是在 10 次提交限制下、对数千名人类选手的锦标赛表现,隐藏测试带对抗用例、零部分分。HumanEval、MBPP 的百分比是单次生成通过短函数单元测试的比例。两篇论文都没报对方的指标,所以不存在同口径对比。
Code Llama 能做竞赛编程题吗?
Code Llama 论文没有在竞赛题上评测,本站没有可引用的数字。已知的是它统治的是短函数写作类基准,而竞赛题要求的是在隐藏测试下选择算法,另一种能力剖面。为这种场景设计的是 AlphaCode 那一脉:大规模采样加行为筛选的系统。
AlphaCode 每个问题用多少采样?
最多一百万个候选程序。约 99% 挂在题面样例测试上被丢弃,幸存者按在模型自造输入上的行为聚类,每个簇交一个代表,凑足比赛限定的 10 次提交。前 54.3% 是整条流水线的产出,不是单次生成的成绩。
今天哪个能真正跑起来?
Code Llama。权重开放,许可证允许研究和商用,有 7B、13B、34B、70B 四档,7B、13B、70B 的基础版和 Instruct 版支持填空补全。AlphaCode 以研究成果形式发表,它的模型只是流水线的一环,而「每题最多百万采样」的算力成本不是能部署的东西。
两条路线各自留下了什么?
AlphaCode 留下的是一个观念:生成加大规模采样加行为筛选,可以赢过单次更聪明的生成,这是今天智能体编程 harness 的种子。Code Llama 留下的是「开放权重代码模型即基础设施」:一个谁都能微调、量化、商用的宽松基座,并用 Python 7B 反超通用 70B 证明了代码特化的力量。