
Keye-VL 2.0 与 InternVideo3 对比:长上下文对小模型
Keye-VL 2.0 走稀疏注意力长上下文路线(LongVideoBench 74.1);InternVideo3 用 80 亿小模型加智能体回路(Video-MME +2.7)。
两种买法
两篇论文都用开源权重做长视频理解,但把复杂度花在了几乎相反的地方。Keye-VL 2.0 是系统工程路线:30B-A3B 混合专家模型,只激活约 30 亿参数;把 DeepSeek Sparse Attention 改造进 GQA 多模态架构,配上自定义 kernel 和 256K 训练上下文,目标是让一小时视频一次前向就过完,而且 serving 成本可控。
InternVideo3 是小预算路线:上海 AI Lab 和南京大学的 80 亿稠密模型,单遍跑 Video-MME 拿 73.8;然后不扩上下文窗口,而是套一层叫 MCR(多模态上下文推理)的智能体回路,让它回头重看片段、给听错的片段补跑语音识别、回答前先核验。这套回路把 Video-MME 从 73.1 抬到 75.8。
所以真正的问题不是”哪个模型更好”,而是:这笔钱你宁愿花在训练期的长上下文基础设施上,还是花在推理期的工具调用上。
关键数字
| 测量项 | Keye-VL 2.0(30B-A3B) | InternVideo3(8B) | 设定与来源 | 同口径? |
|---|---|---|---|---|
| 激活参数 | 约 30 亿(MoE 总 300 亿) | 80 亿稠密 | 两篇论文架构节 | 是,定义如此 |
| 上下文 | 256K 训练上下文 | 未给训练值;M2LA 单张 H200 跑 76.8 万 token | Keye-VL 页 / InternVideo3 页 | 否(训练目标对 serving 演示) |
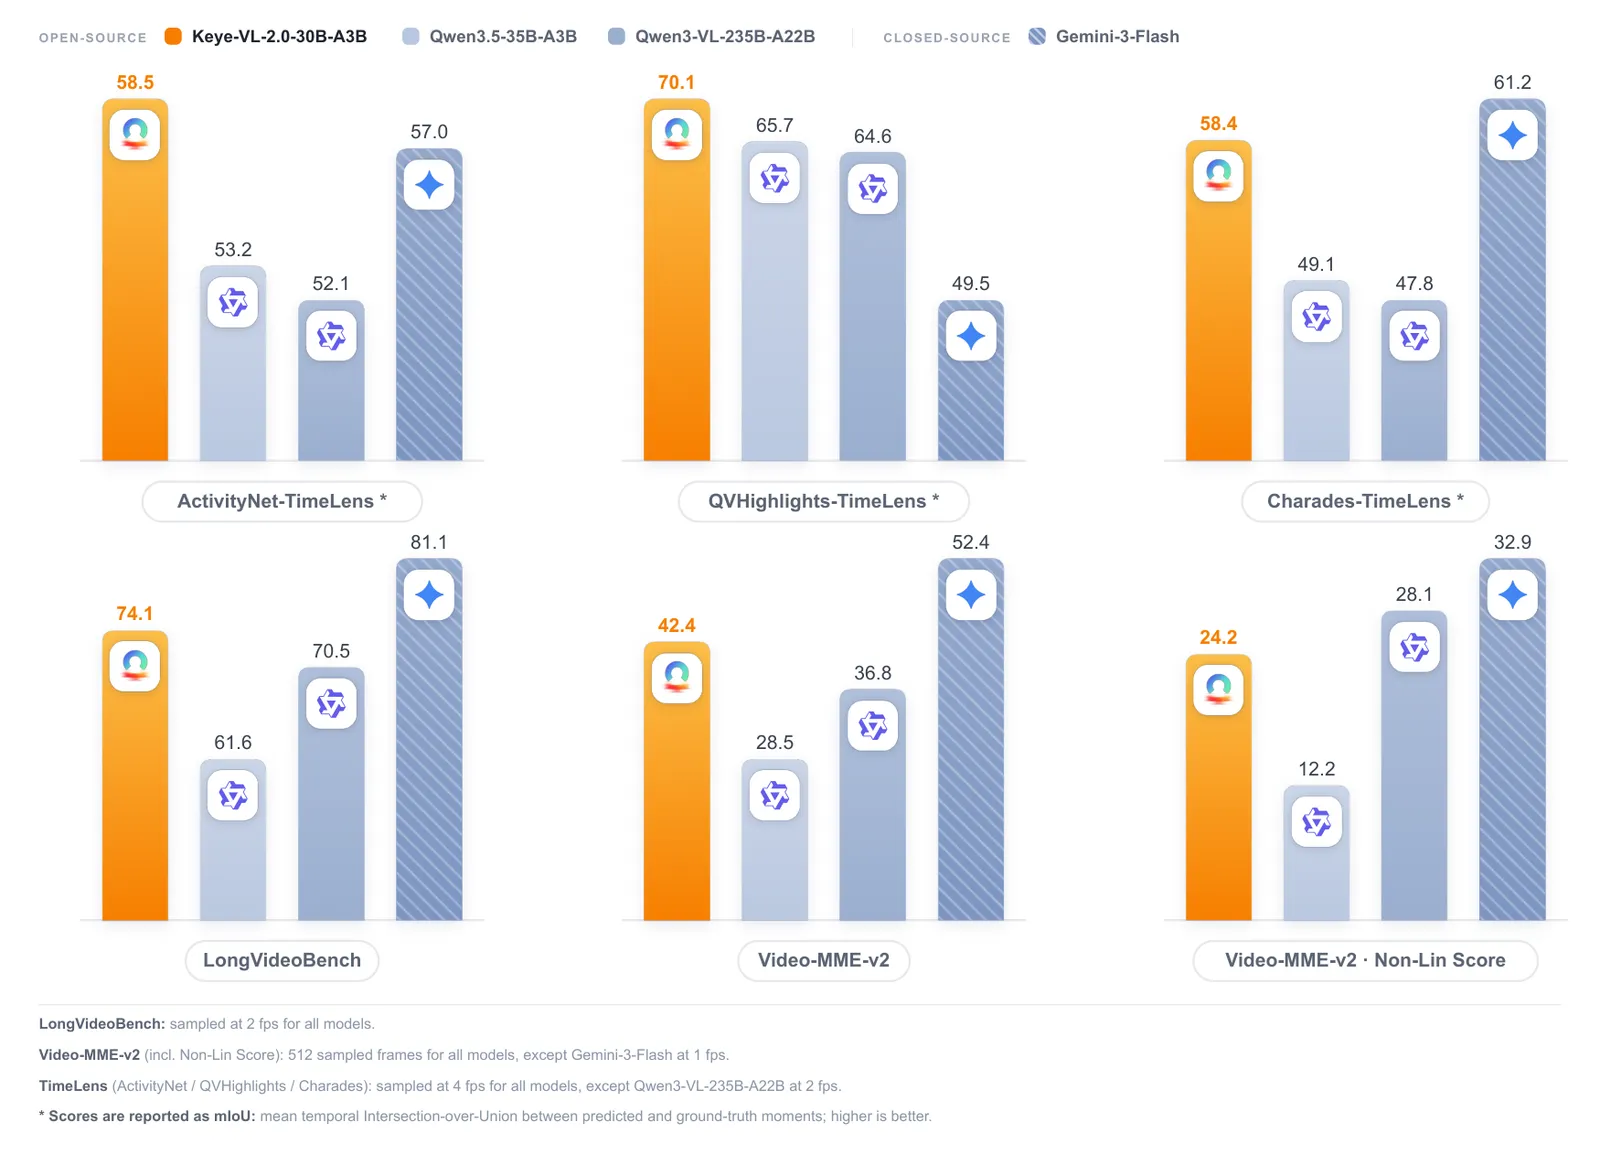
| LongVideoBench | 74.1 | 未报告 | Keye-VL 页自家表格(Qwen3-VL-235B-A22B Thinking:70.5) | n/a |
| Video-MME | v2:64 帧 35.3,512 帧 42.4 | 73.8 单遍 | 协议版本不同 | 否:v1 对 v2,不能比 |
| MLVU | 只说”更大基线在同等区间”,无数 | 77.3(InternVideo2.5-7B:72.8;Qwen3-VL-8B:57.6) | InternVideo3 页 | 否 |
| EgoSchema | 未报告 | 76.6(InternVideo2.5-7B:63.9;Qwen3-VL-8B:69.8) | InternVideo3 页 | 否 |
| 智能体推理 | tau2-Bench 82.6,VitaBench 33.1 | MCR 回路:Video-MME 73.1→75.8(+2.7) | 完全是不同基准 | 否 |
| 推理效率 | DSA:128K 下 prefill 省 3 倍以上、decode 省 5 倍以上(对全量注意力) | M2LA:单张 H200 跑 76.8 万 token,基座 51.2 万即 OOM | 各自的技术栈 | 否 |
| 前沿参照 | n/a | Gemini 3 Pro 在 Video-MME 上 88.6 | InternVideo3 页 | 否 |
这张表要连着”没有的部分”一起读:没有任何一行是两款模型在同一基准同版本协议下的对跑,所以表里没有一个格子是正面交锋的结果。最接近受控对比的,是各自论文的内置基线列:Keye-VL 2.0 在自家表格里对 Qwen3-VL-235B-A22B Thinking(LongVideoBench 74.1 对 70.5);InternVideo3 拿 80 亿对 70 亿的前代和同尺寸 Qwen3-VL-8B(Video-MME 73.8 对 65.1 和 71.4)。
为什么 35.3 不比 73.8 差
这里最容易踩的坑,就是把 Keye-VL 2.0 的 35.3 到 42.4”Video-MME”和 InternVideo3 的 73.8 排在一起比大小。Keye-VL 页报的是 Video-MME v2,一个更难的新版本,同一份结果里帧数从 64 加到 512,分数从 35.3 涨到 42.4。InternVideo3 的 73.8 是原始版 Video-MME。名字同源,协议不同,难度不同。任何把两者相减的页面,都是在编造论文从未主张过的差距。
能下的结论是这样的:InternVideo3 单遍 73.8 对 80 亿模型是强结果,自家表格里压过 Qwen3-VL-8B 的 71.4,但闭源前沿(Gemini 3 Pro 88.6)仍遥遥领先。Keye-VL 2.0 最硬的证据在别处:LongVideoBench 74.1 领先 Qwen3-VL-235B-A22B Thinking 的 70.5,并且三个 TimeLens 时间定位子集全部第一(ActivityNet-TimeLens 58.5、QVHighlights-TimeLens 70.1、Charades-TimeLens 58.4)。
两款模型到底各买到什么
Keye-VL 2.0 买到的是上下文窗口。把 DeepSeek Sparse Attention 改造进 GQA 多模态骨干,加上 Chunk ViT、ViT-LM 异构并行和自定义 DSA kernel,256K 视频上下文才变得可服务:论文称 DSA 专项优化在 128K 下把 prefill 成本砍掉 3 倍以上、decode 砍掉 5 倍以上。后训练分阶段叠在上面:跨模态多教师在线策略蒸馏,再是 Context-RL 和 Video-RL,分别盯长上下文检索、时间定位和智能体行为。它的潜台词是:所谓智能体视频理解,大部分可以烘进一次长上下文前向里。
InternVideo3 买到的是反面:模型保持小巧,把钱花在推理期。MCR 回路带来 Video-MME +2.7(73.1→75.8),涨的不是权重而是脚手架:多出来的几遍前向用来重看片段、转写视觉路径漏掉的语音、或者定稿前先核答案。它另一块结构性工作 M2LA 注意力是管道工程:把既有 GQA 骨架撑到单张 H200 跑 76.8 万 token,而基座架构 51.2 万就显存溢出。注意这和搜索智能体 harness 是同一个道理:MCR 回路的增益属于脚手架和工具预算,把它记到 80 亿网络头上,等于低估了你真正要部署的东西。
怎么选
- 一小时级视频、一遍过完、serving 成本要控住:选 Keye-VL 2.0。它的整套栈,从稀疏注意力、30 亿激活参数到 decode 优化,就是为”长视频塞进一次 256K 上下文且不用巨型稠密模型”而存在,LongVideoBench 和 TimeLens 的数字就是证据。
- 部署预算紧、延迟可以换、推理侧有工具可用:选 InternVideo3 的 80 亿模型。稠密 80 亿的托管成本远低于带自定义 kernel 的 30B MoE,而 +2.7 的 MCR 增益说明在部分基准上,推理期工具调用可以替代规模。
- 你要的是基准分数而不是哲学:两边表格不可直接比,所以按你的工作负载选基准。LongVideoBench 和时间定位偏 Keye-VL 的证据;Video-MME v1、MLVU(77.3)、EgoSchema(76.6)是 InternVideo3 有数的地方。
- 你要的是前沿模型:两篇论文都很坦诚自己不是。InternVideo3 的页面写明 Gemini 3 Pro 在 Video-MME 上 88.6,且更新的版本(Qwen3.5+、GLM、Kimi)已超过它;Keye-VL 2.0 的页面承认 Video-MME 和 MLVU 上闭源或更大的开源基线仍在同一区间。
局限与存疑
最大的缺口是缺少共享评测:两篇论文没有任何一个协议把两款模型打在同一个基准版本上,所以这个对比结构上只是两组证据的并置,不是一场赛跑。其次,两个”上下文”数字量的是不同东西:256K 是 Keye-VL 2.0 的训练上下文,76.8 万是 InternVideo3 的 M2LA 在单张 H200 上的 serving 演示,别读成谁大谁小。第三,智能体主张落在不同基准上:Keye-VL 2.0 的工具使用证据(tau2-Bench 82.6、VitaBench 33.1)是模型级能力分,InternVideo3 的 +2.7 是单一基准上的 harness 级增量,这个增量在 MLVU 或 EgoSchema 上是否还成立,论文没有给。最后是复现性:Keye-VL 2.0 的成本曲线依赖它的稀疏 kernel 和 serving 栈,InternVideo3 的 MCR 增益依赖部署整条智能体回路;两种情况下,只发 checkpoint 都不等于发出那个分数。
常见问题
Keye-VL 2.0 和 InternVideo3 哪个更好?
没有实测的正面交锋,因为两篇论文几乎不重叠地报基准版本。Keye-VL 2.0 最硬的数字是 LongVideoBench 74.1 和三个 TimeLens 子集第一;InternVideo3 的是 80 亿模型的 Video-MME 73.8、MLVU 77.3、EgoSchema 76.6。能下的结论更窄:小时级单遍视频选 Keye-VL 2.0 证据更足,小模型加智能体回路的部署选 InternVideo3。
为什么 Keye-VL 2.0 的 Video-MME 分数比 InternVideo3 低那么多?
因为那是同名的不同基准。Keye-VL 2.0 报的是更难的 Video-MME v2:64 帧 35.3,512 帧 42.4;InternVideo3 的 73.8 是原始版 Video-MME。拿 42.4 比 73.8 是协议错配,不是能力差距。
InternVideo3 的智能体回路到底加了什么?
它的 MCR(多模态上下文推理)回路把 Video-MME 从 73.1 抬到 75.8,+2.7 的增益记在 harness 头上而不是权重头上。回路可以回头重查视频片段、给视觉路径听错的片段补跑语音识别、或在回答前核验论断。这个增量在别的长视频基准上是否保持,论文没有展示。
Keye-VL 2.0 和 InternVideo3 处理长上下文的方式有什么不同?
Keye-VL 2.0 把长上下文做进训练:DeepSeek Sparse Attention 改造进 GQA 多模态骨干、256K 训练上下文、kernel 级优化(论文称 128K 下 prefill 省 3 倍以上、decode 省 5 倍以上)。InternVideo3 保持 80 亿稠密模型,用 M2LA 注意力在 serving 层扩容:单张 H200 跑 76.8 万 token,基座架构 51.2 万就 OOM:一个是训练级方案,一个是推理级方案。